
Оформление
AI-провайдер
Раздел AI-провайдер подключает языковую модель, на которой работает AI-помощник, и разрешает выпуск MCP-токенов. Доступен администратору. Параметры применяются сразу после сохранения.
Модель в поставку платформы не входит — её выбирает и разворачивает заказчик. Подойдёт и облачный сервис, и сервер в собственной сети: платформа обращается к указанному адресу и не различает, где именно модель работает.
Если модели ещё нет, начните с двух подтем: Где взять модель — про сервисы и доступность из сети организации, Выбор модели — про то, какая модель подходит помощнику и какие параметры ей задать.
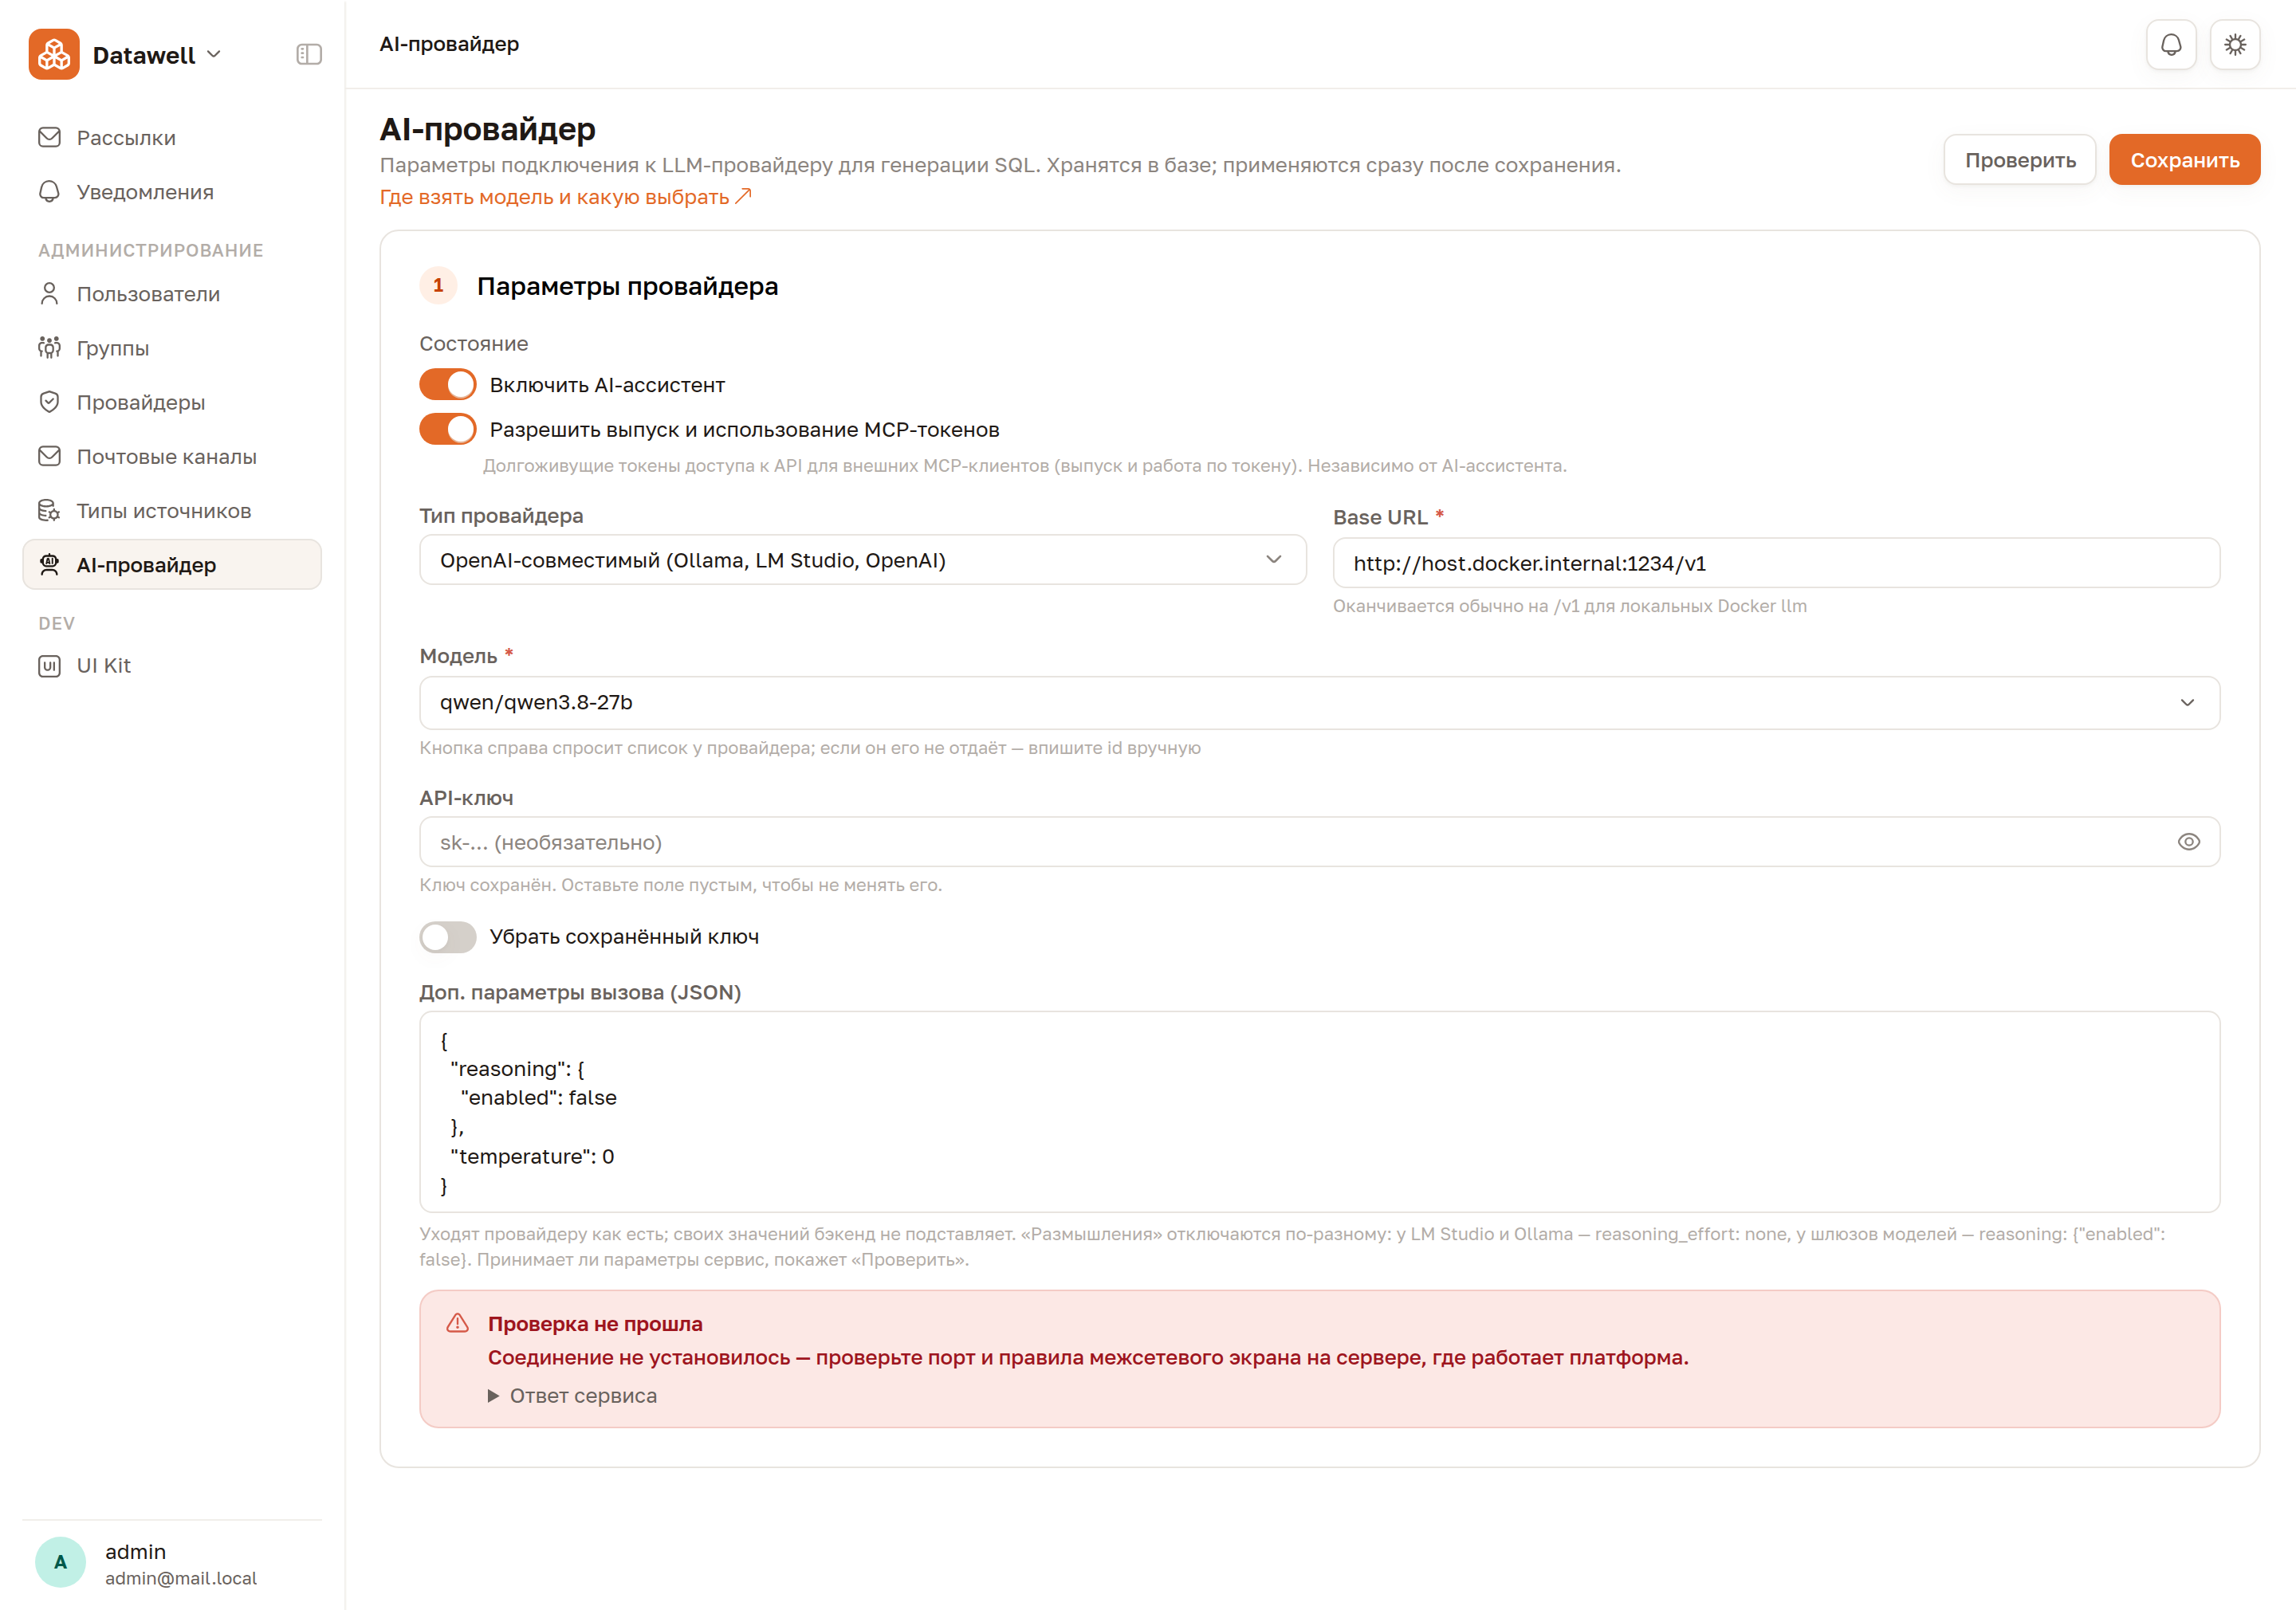
Состояние
| Переключатель | Что делает |
|---|---|
| Включить AI-ассистент | Показывает пользователям кнопки помощника. Без настроенной языковой модели помощник работать не будет |
| Разрешить выпуск и использование MCP-токенов | Открывает вкладку «Доступ для ИИ» в профиле. Работает независимо от помощника — токены дают внешним клиентам доступ к API, а не к модели |
Выпуск токенов включается тремя условиями сразу: этим переключателем, членством пользователя в группе «Пользователи AI mcp» — см. Пользователи и группы — и типом учётной записи «Создатель» или «Исследователь»: наблюдателю токены не выдаются.
Параметры подключения
| Поле | Описание |
|---|---|
| Тип провайдера | «OpenAI-совместимый» — облачные сервисы с этим API и серверы, которые разворачивают у себя (Ollama, LM Studio); либо Anthropic |
| Base URL | Адрес API модели. У серверов с OpenAI-совместимым API обычно оканчивается на /v1 |
| Модель | Идентификатор модели у провайдера, например qwen/qwen3.8-27b. Кнопка справа в поле запрашивает список у провайдера — см. Выбор модели из списка. Какую выбрать — см. Выбор модели |
| API-ключ | Серверу в своей сети обычно не нужен, облачному сервису и Anthropic — обязателен. В базе хранится зашифрованным — тем же ключом платформы, что и пароли источников |
| Доп. параметры вызова (JSON) | Необязательное поле: что ещё передать модели вместе с запросом — см. Доп. параметры вызова |
Модель на той же машине, что и платформа
Если платформа работает в Docker, а модель запущена на самом хосте, localhost внутри контейнера указывает на сам контейнер. Используйте http://host.docker.internal:<порт>/v1. Для модели на другом сервере сети укажите его адрес обычным образом.
Доп. параметры вызова
Содержимое поля уходит модели вместе с запросом как есть: платформа список ключей не ограничивает, он зависит от выбранного сервиса. Записывается объектом JSON:
json
{"reasoning_effort": "none", "max_tokens": 900}Служебные поля запроса (модель, текст запроса, режим потоковой выдачи) платформа заполняет сама — из этого поля они не подменяются, поэтому опечатка не отправит запрос на другую модель.
Своих значений платформа не добавляет
Чего нет в этом поле, того нет и в запросе: параметр берёт значение по умолчанию у самого сервиса. Это касается и temperature — если он важен, задайте его здесь явно.
Для генерации SQL обычно нужен предсказуемый ответ, а не разнообразие формулировок: с {"temperature": 0.1} один и тот же вопрос чаще даёт дословно совпадающий запрос, при 0.7 форма запроса меняется от прогона к прогону. Правильность SQL при этом не страдает.
Сервисы относятся к незнакомым параметрам по-разному: LM Studio и Ollama их пропускают, OpenAI отвечает ошибкой «Unrecognized request argument». Поэтому набор проверяется не по справочнику, а кнопкой Проверить.
У рассуждающих моделей отключайте рассуждения
Модель с внутренними рассуждениями (reasoning) тратит на них основное время ответа, а при небольшом лимите токенов SQL может в ответ не попасть — в интерфейсе это выглядит как долгое «Ассистент печатает» или как обрезанный запрос.
Название параметра зависит от сервиса: у агрегаторов моделей это {"reasoning": {"enabled": false}}, у LM Studio и Ollama — {"reasoning_effort": "none"}. Часть моделей отключать рассуждения не позволяет — подробности в разделе Отключение рассуждений.
Разница на модели qwen/qwen3.8-27b в LM Studio — один и тот же запрос «выручка по городам за 2025 год, только категория Электроника, топ-10», модель уже загружена в память:
| Доп. параметры | Ответ помощника | Пробный вызов кнопкой «Проверить» |
|---|---|---|
| пусто — модель рассуждает | 8,3–9,9 с | 4,0–4,5 с |
{"reasoning_effort": "none"} | 1,5–1,9 с | 0,2–0,4 с |
SQL в обоих случаях верный — разница только во времени. Настройка из запроса перекрывает переключатели в самом LM Studio, поэтому задавать её достаточно здесь. Сработал параметр или нет, показывает Проверить: в результате пишется, сколько токенов ушло на размышления.
max_tokens задавайте осознанно
Ответы помощника короткие, и лимит обычно не нужен: от зацикливания страхует таймаут вызова. Он полезен там, где ограничивают счёт за запрос, а у Anthropic обязателен — если не задать, платформа подставит 1024.
Если лимита не хватило, помощник не отдаёт обрезанный запрос: он отвечает ошибкой «Ответ модели неполный». В проверке тот же случай виден пометкой «ответ оборван по лимиту токенов». При включённых размышлениях они тратят тот же бюджет и могут израсходовать его до начала ответа.
Выбор модели из списка
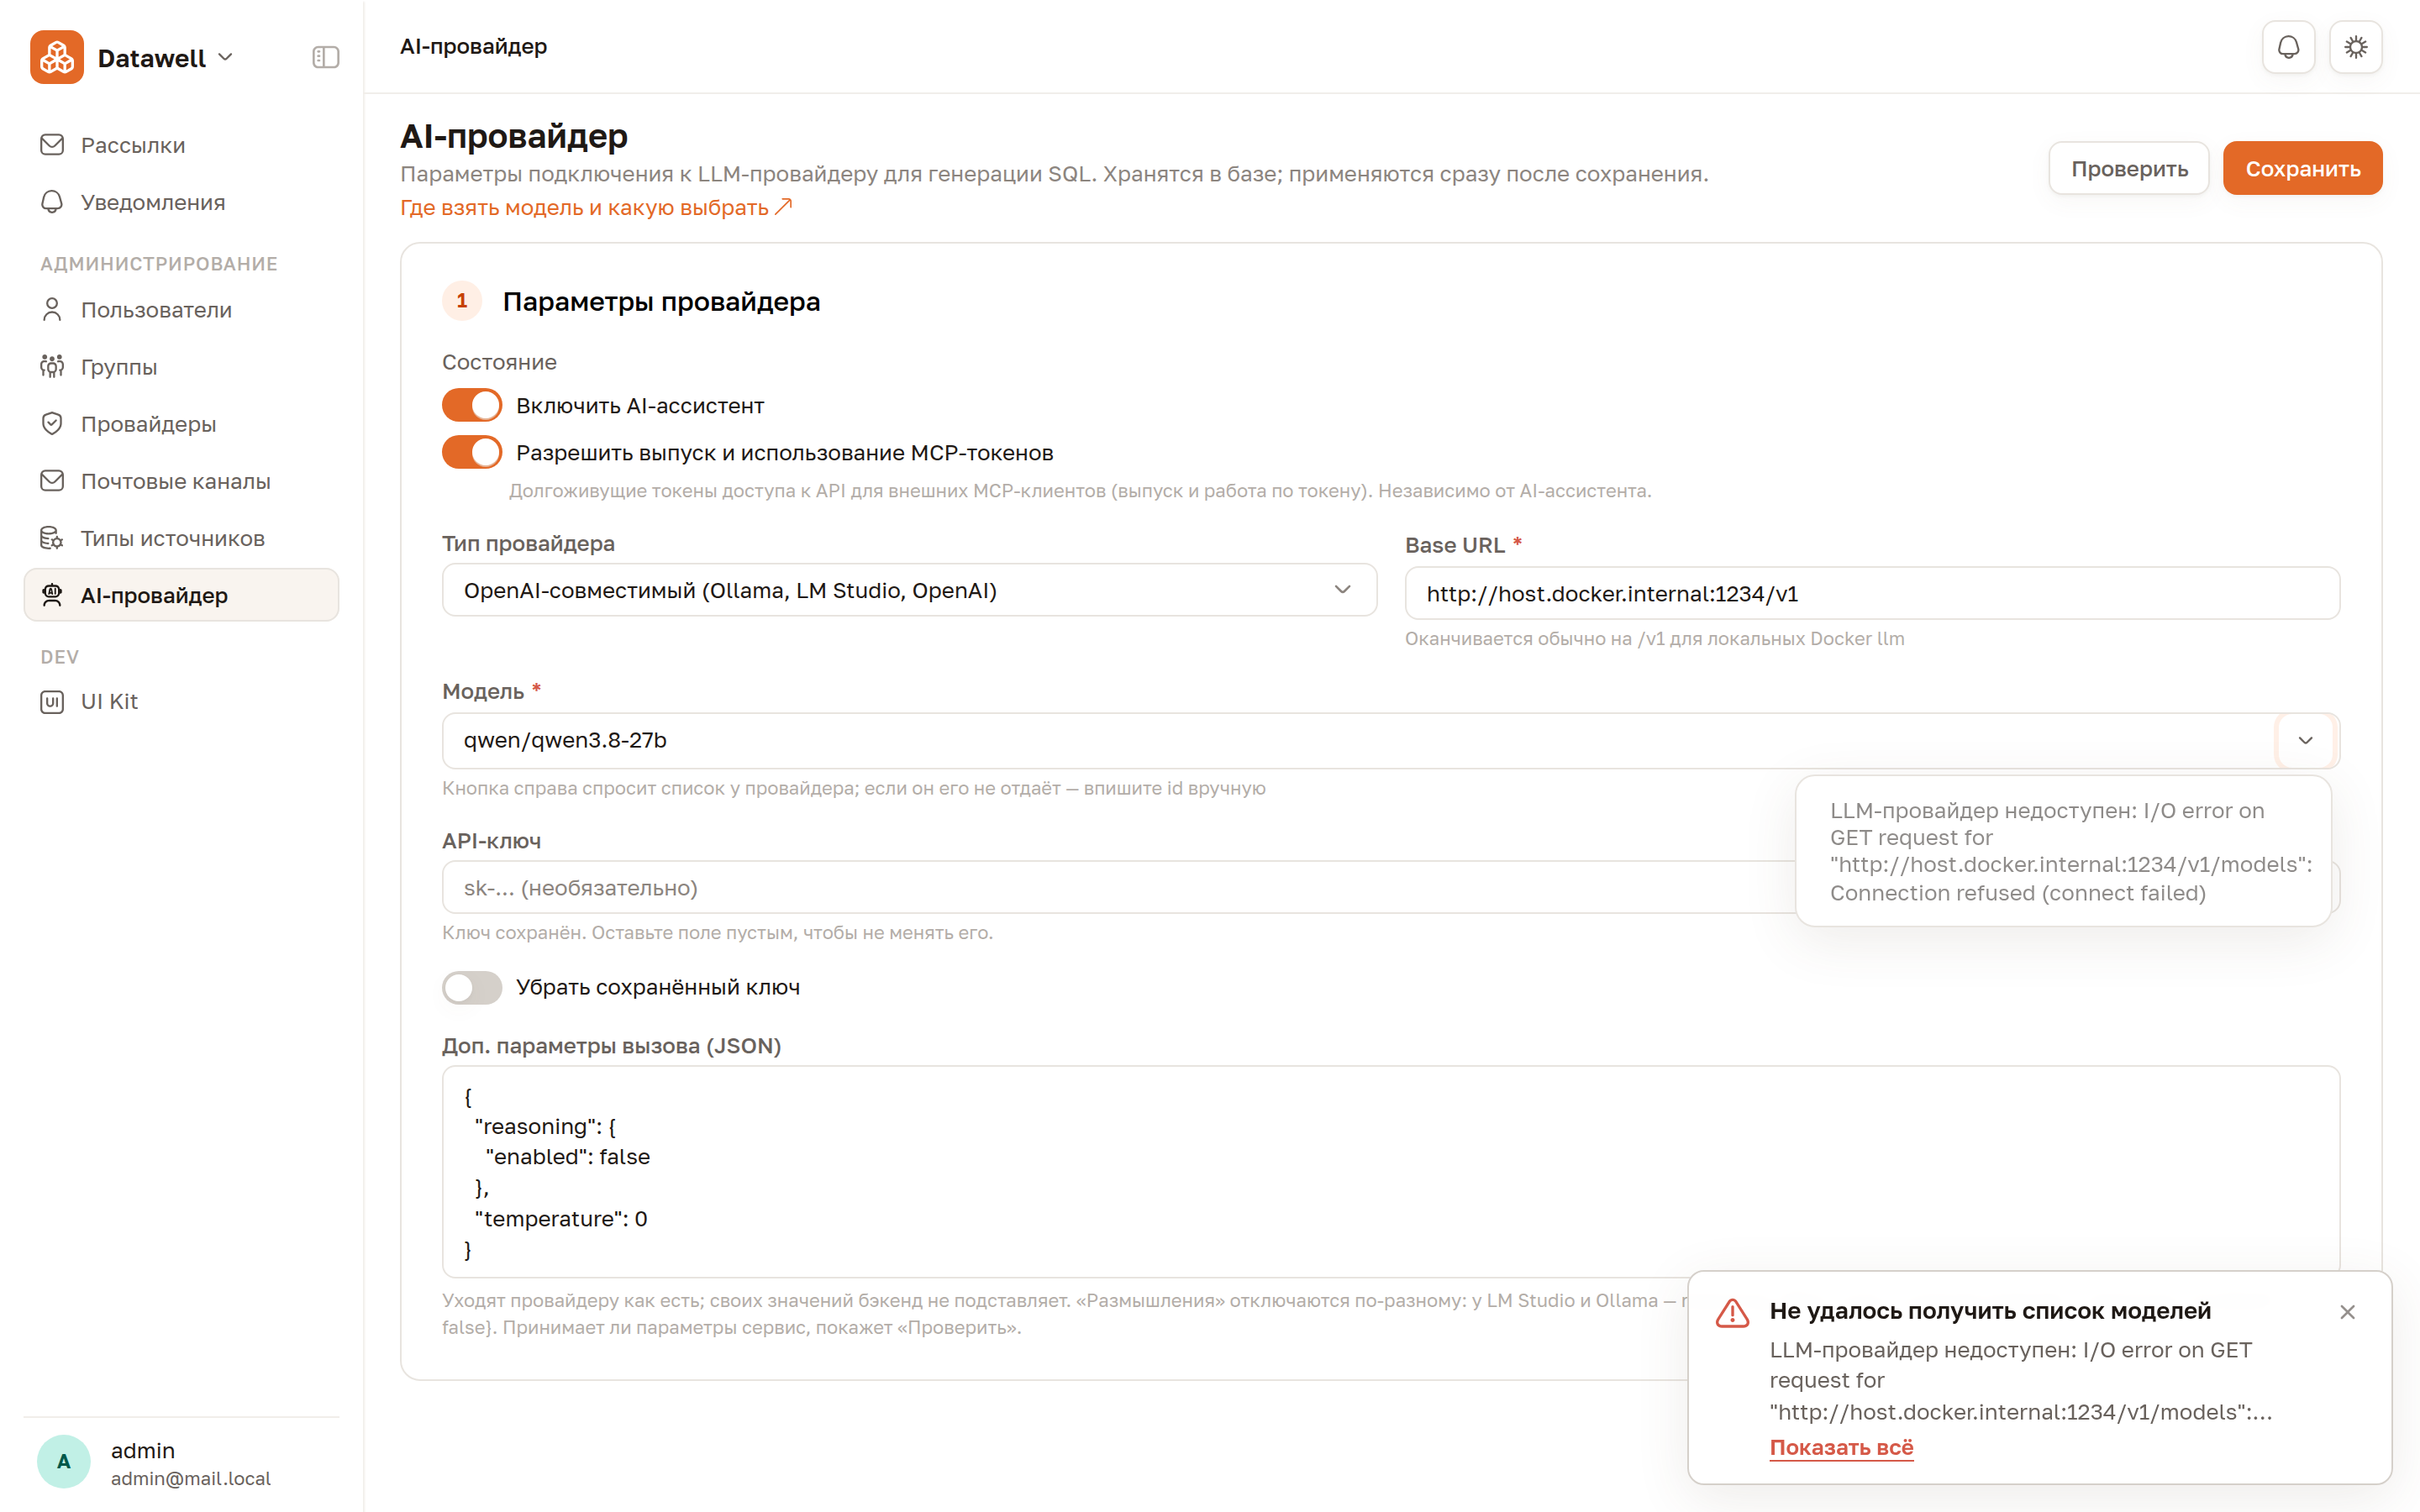
Кнопка справа в поле Модель запрашивает список у самого провайдера и показывает его выпадающим меню, отсортированным по алфавиту. Это надёжнее ручного ввода: идентификатор не придётся списывать из каталога, а опечатка не всплывёт при первом же вопросе помощника.
Список запрашивается по тем параметрам, что сейчас в форме, — адресу и ключу. Сервис, не умеющий перечислять модели, вместо списка даёт подсказку «Провайдер не отдаёт список моделей — введите id вручную»: это не ошибка настройки, ручной ввод остаётся рабочим.
Проверка
Кнопка Проверить отправляет провайдеру пробный запрос параметрами из формы — до сохранения. Так подбирают новый сервис или модель, не трогая рабочую конфигурацию: если проверка не прошла, в базе остаётся прежняя настройка.
Удачная проверка показывает показатели вызова одной строкой и сам ответ модели:
| В результате | Что означает |
|---|---|
| Время ответа | Сколько занял вызов целиком |
| Токенов ответа | Сколько сгенерировала модель |
| «Без размышлений» | Модель не тратила токены на рассуждения — параметр отключения сработал |
| «N на размышления» | Рассуждения включены и съедают время; их стоит отключить |
| «Ответ оборван по лимиту токенов» | Сработал max_tokens — ответ неполный |
| Ответ модели | Что именно ответил сервис на пробный запрос |
Модель и адрес в результате не повторяются — они видны в самой форме. Их платформа называет только тогда, когда проверялось не то, что сохранено: строкой «Проверены параметры формы, они ещё не сохранены: <модель> · <адрес>».
Ключ в проверку берётся сохранённый, если поле API-ключ пустое. Чтобы проверить сервер, которому ключ не нужен, включите Убрать сохранённый ключ — тогда запрос уйдёт без ключа.
Если проверка не прошла
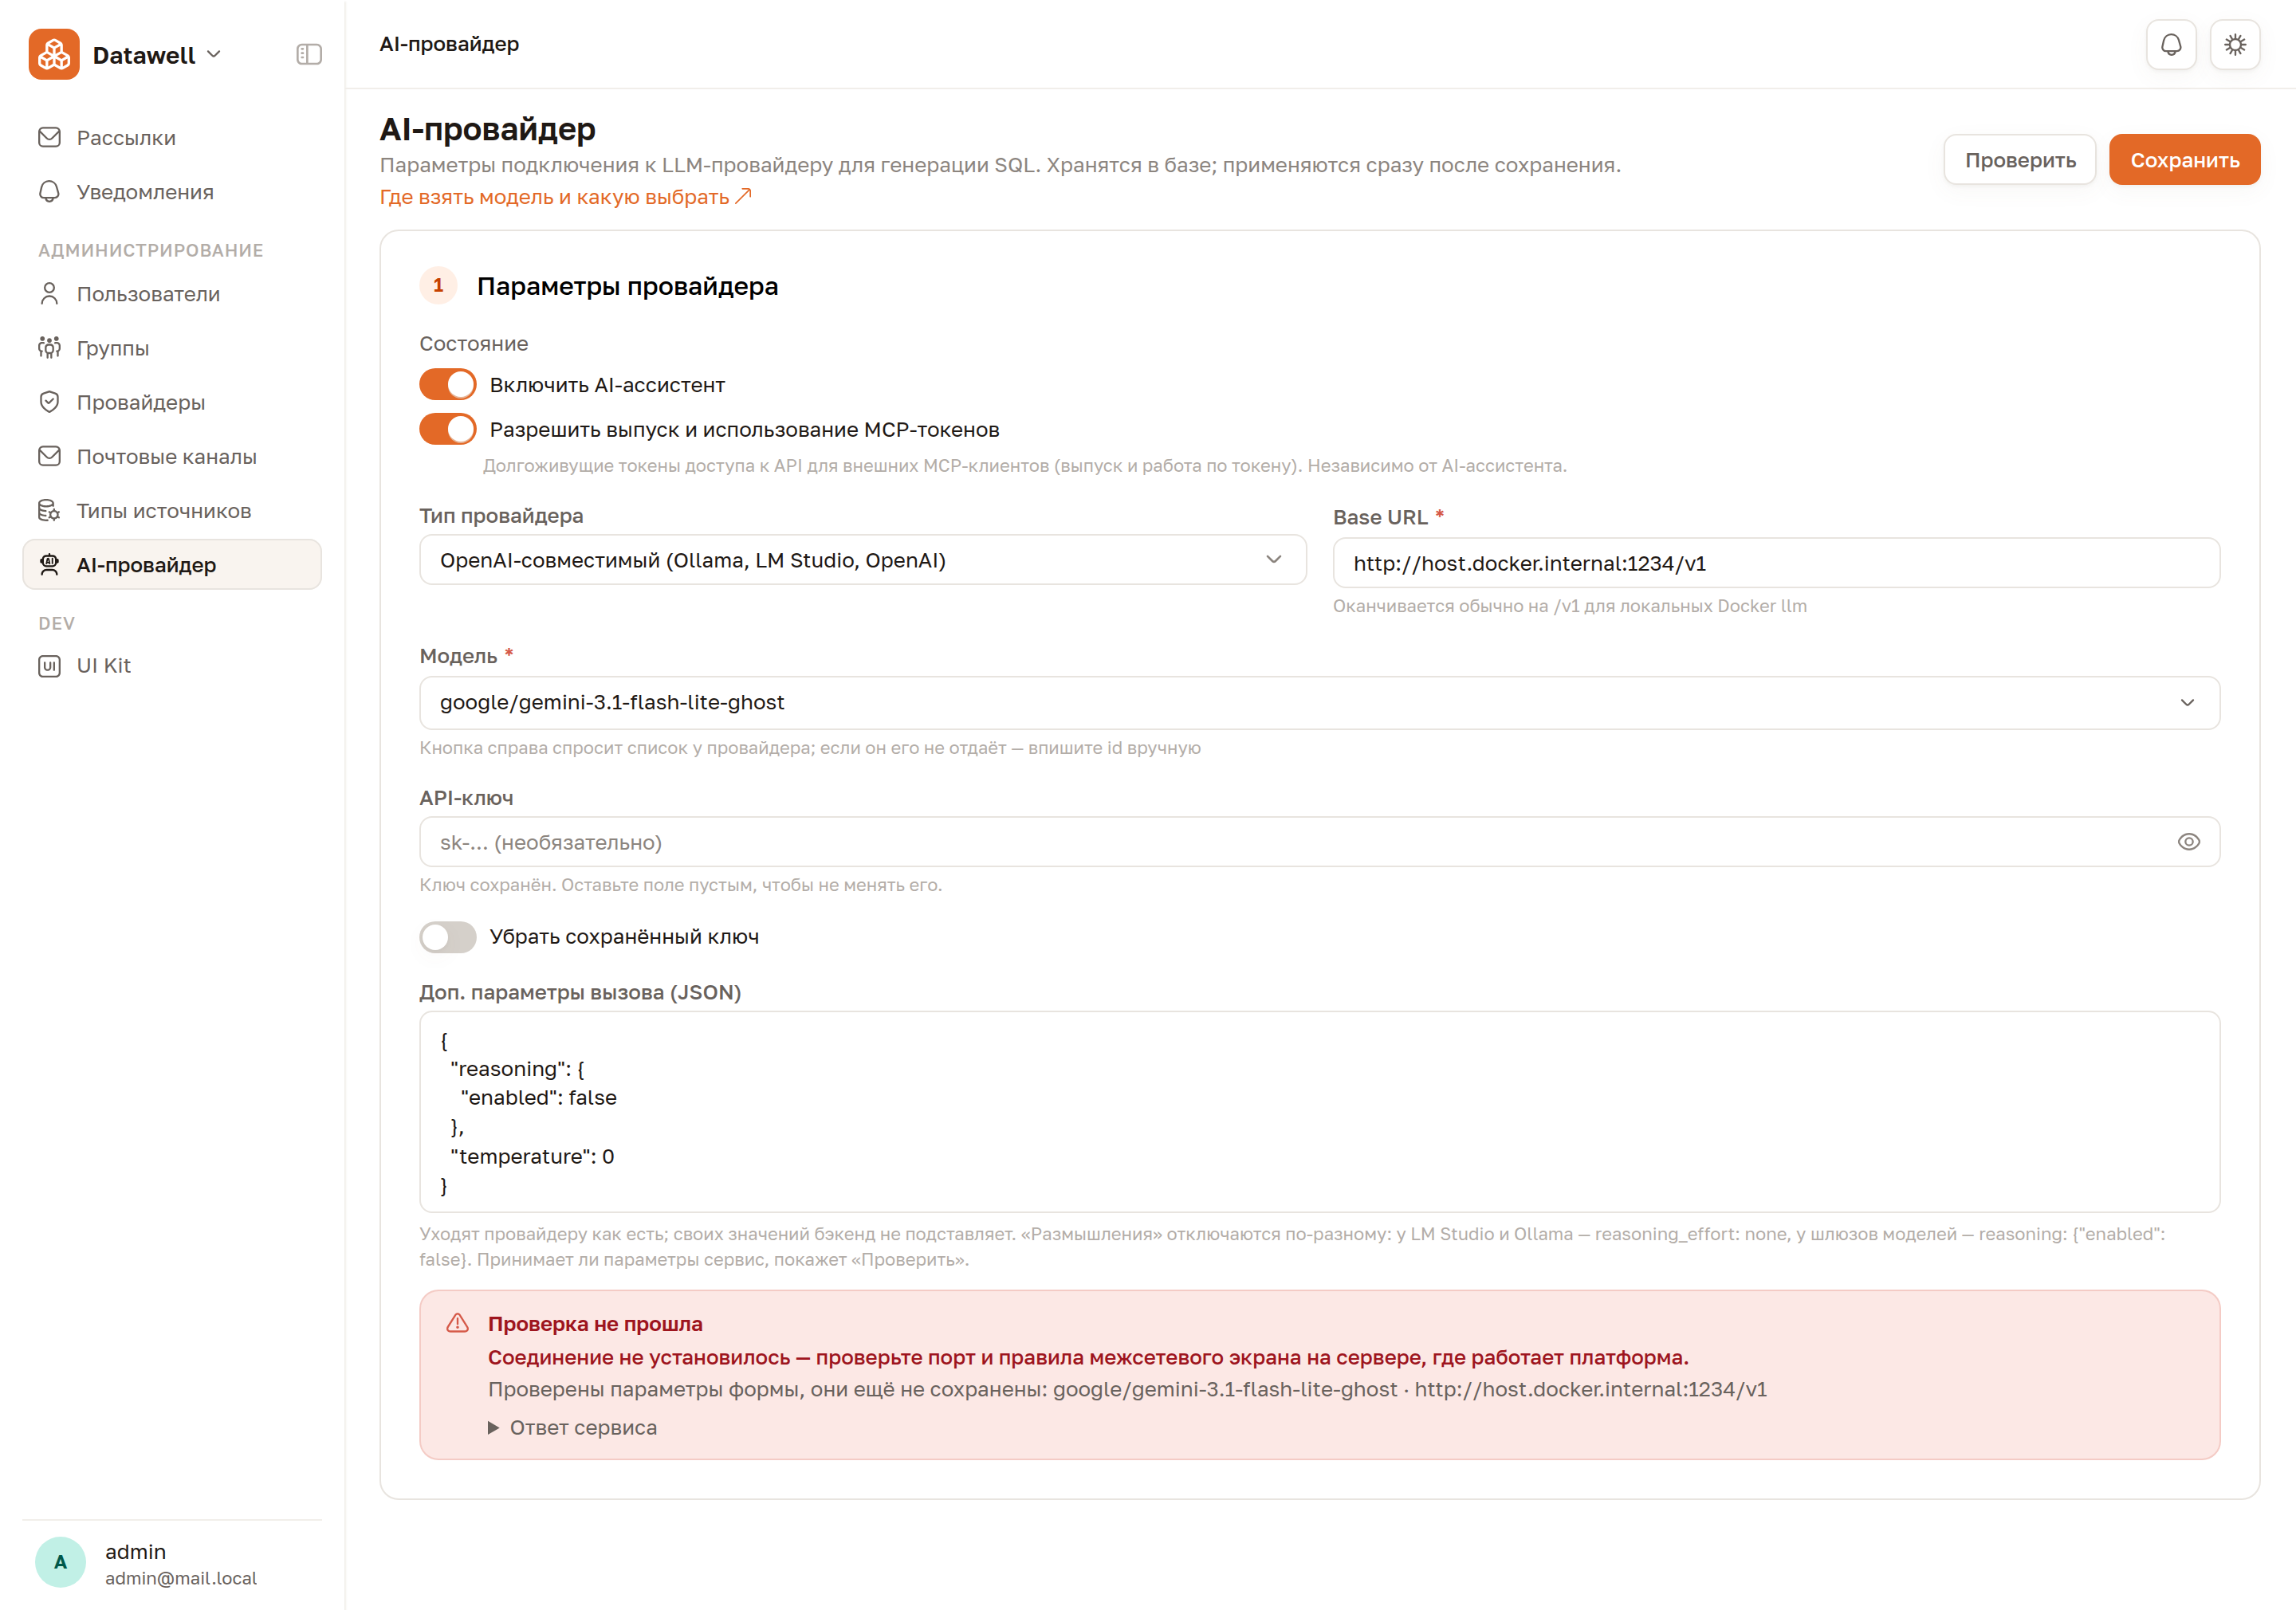
Платформа называет причину и что с ней делать. Полный ответ сервиса не мешается под ногами: он раскрывается ссылкой Ответ сервиса — там же перечислены доп. параметры, которые уходили в запрос. Различаются:
| Причина | Что делать |
|---|---|
| Регион заблокирован — быстрый отказ, до проверки ключа | Выбрать сервис, доступный из вашей сети, см. Где взять модель |
| Ключ не принят | Канал до сервиса работает — проверить сам ключ |
| Модель не найдена | Сверить идентификатор со списком моделей провайдера |
| Модель не разрешает отключать размышления | Убрать параметр отключения из доп. параметров |
| Квота исчерпана | Взять другую модель или подключить собственный ключ вендора |
| Лимит токенов кончился до начала ответа | Увеличить max_tokens в доп. параметрах или убрать его |
| Сервис не ответил за отведённое время | Для модели в своей сети — обычно первый запрос после запуска, повторите |
| Соединение не установилось | Проверить адрес, порт и правила межсетевого экрана на сервере платформы |
Если ответ пришёл, но медленно, проверка предупреждает отдельно: на один вопрос платформа обращается к модели до трёх раз, и при такой скорости цепочка упрётся в таймаут вызова.
Первый вызов после запуска сервера модели идёт заметно дольше остальных — десятки секунд против долей секунды у последующих: модель в этот момент загружается в память.
Дальше проверьте помощника в работе под учётной записью создателя — у администратора датасетов нет: откройте любой датасет → Создать SQL-блок → AI-помощник и задайте простой вопрос.
Опечатка в названии модели проверкой не ловится
Локальные серверы подставляют вместо неизвестного названия ту модель, что у них уже загружена, и отвечают как ни в чём не бывало. Проверка в этом случае показывает «ok», хотя работает не та модель, которую вы указали. Берите название из списка по кнопке в поле Модель — так опечатка исключена.
Что дальше
- Где взять модель — сервисы моделей, доступность из России и промежуточный сервер.
- Выбор модели — на что смотреть при выборе и сколько стоит работа помощника.
- AI-помощник — как помощник выглядит для пользователя.