
Оформление
Файлы и S3
Два типа источников читают не базу, а файлы: Файл — загруженный с диска, S3 — набор объектов в хранилище. Разбирает их платформа одинаково, поэтому блок настроек у них общий.
Файл
Тип Файл загружает данные напрямую: мастер состоит из шагов «Тип источника → Загрузка файла → Готово».
Поддерживаются CSV, TSV, XLSX, XLS, JSON, JSONL, NDJSON, PARQUET, AVRO, GZ, ZIP, размер — до 50 МБ. Файл перетаскивается в область загрузки или выбирается кнопкой.
В блоке Разбор файла задаётся, как читать содержимое:
| Параметр | Описание |
|---|---|
| Кодировка | Как декодировать текст: UTF-8, windows-1251, KOI8-R, IBM866, UTF-16LE, UTF-16BE, ISO-8859-1. По умолчанию определяется автоматически |
| Разделитель | Чем разделены колонки: запятая, точка с запятой, табуляция, вертикальная черта. По умолчанию определяется автоматически |
| Строка заголовка | Номер строки с названиями колонок; всё, что выше, отбрасывается |
| Склеить таблицы файла в одну | Свести записи zip-архива и листы Excel в одну таблицу — см. Файл с несколькими таблицами |
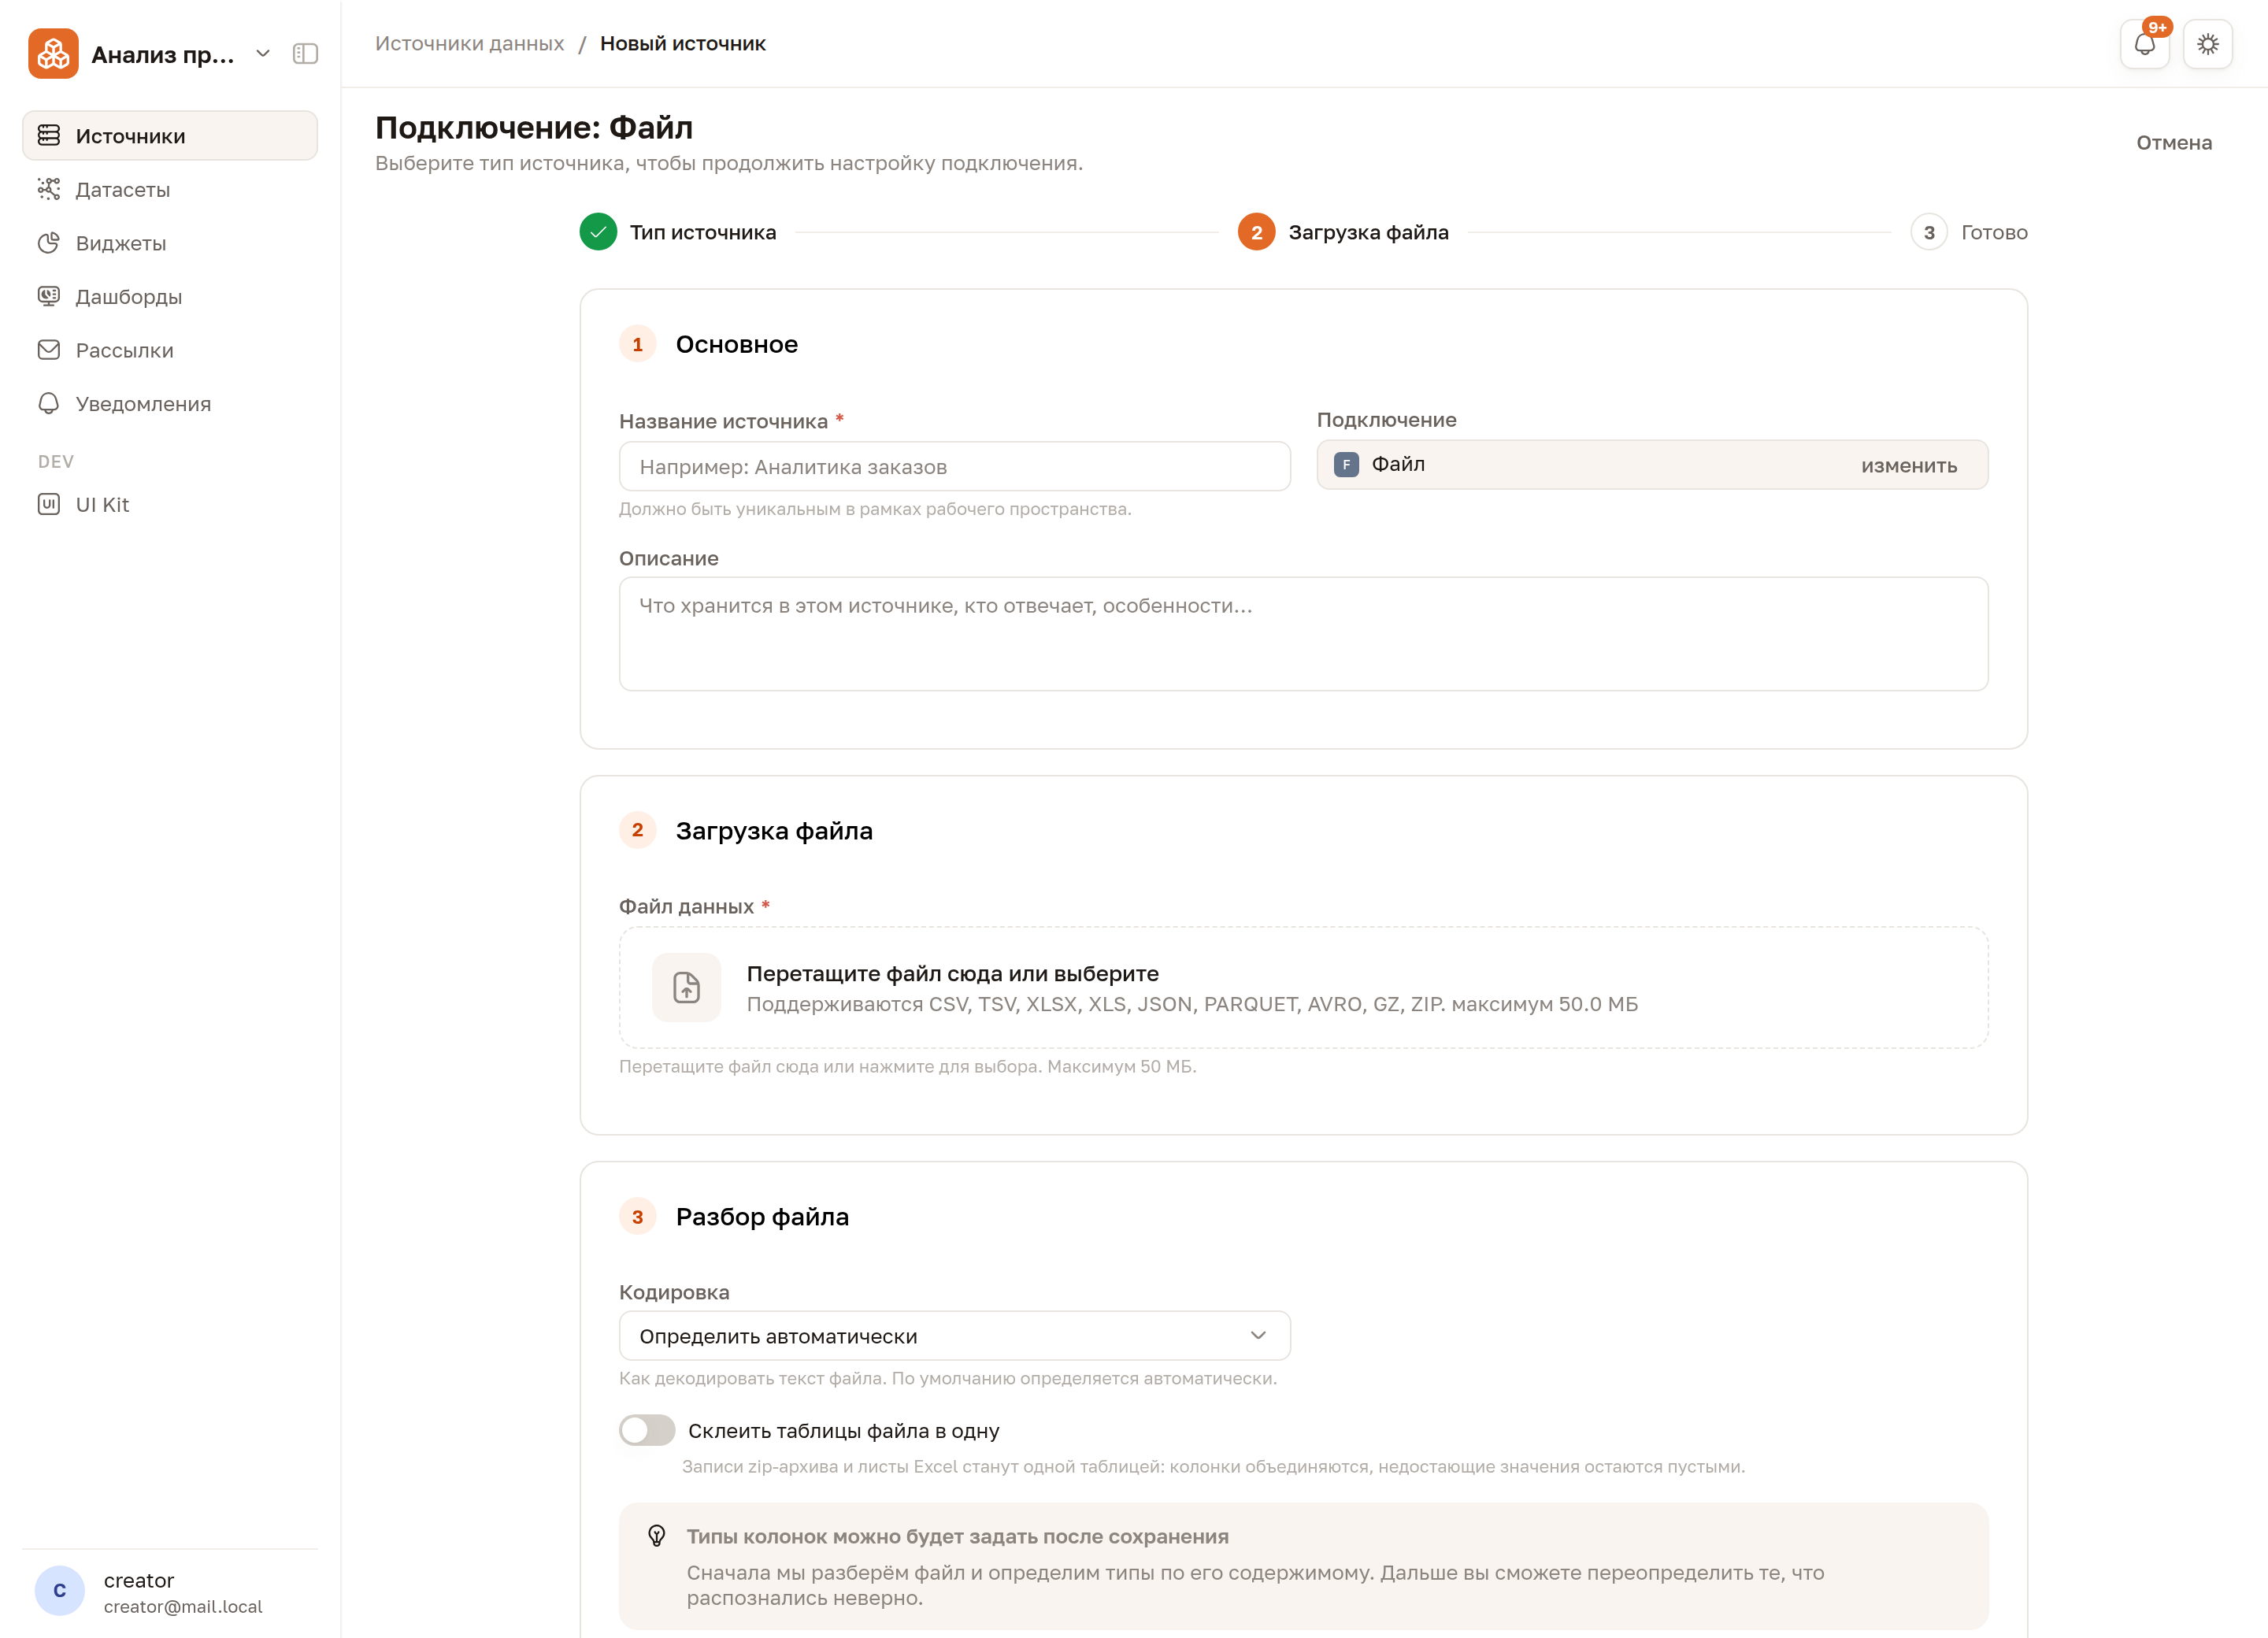
Загруженный файл виден в форме с именем и размером, а нажатие на него позволяет заменить файл, не создавая источник заново.
Что происходит при замене
Прежний файл удаляется из хранилища платформы — вернуться к нему через интерфейс нельзя, держите исходник у себя. Датасеты и виджеты, построенные на этом источнике, остаются на месте и продолжают ссылаться на поля по именам, поэтому набор и названия колонок в новом файле должны совпадать с прежними. Если колонка пропала или переименована, проверьте датасет: поле, которого больше нет в источнике, перестанет отдавать данные.
Автоопределение кодировки работает так: платформа пробует прочитать файл как UTF-8, а если он таким не читается — как windows-1251. В этой кодировке приходят выгрузки из 1С и Excel, поэтому кириллица в них читается правильно.
Разделитель ищется в первой строке файла
Автоопределение смотрит на самую первую строку. Если файл начинается с шапки отчёта («Отчёт о продажах»), разделителя там нет — и вся строка данных станет одной колонкой, даже когда «Строка заголовка» указана верно. В таких файлах задавайте разделитель явно.
Когда пригодится «Строка заголовка»
Выгрузки из учётных систем часто начинаются с шапки: название отчёта, период, пустая строка. Укажите номер строки, в которой действительно находятся названия колонок, — всё, что выше, платформа отбросит. Иначе первой строкой данных станет заголовок отчёта, а колонки получат имена вида «Отчёт о продажах».
После сохранения данные файла доступны так же, как таблица базы: платформа определяет колонки и их типы сама. Таблица называется по имени файла без расширения, а дефисы заменяются подчёркиваниями: загруженный sales-2026.csv превращается в таблицу sales_2026 с колонками order_date (дата), city и category (строки), orders_cnt (целое) и revenue (дробное).
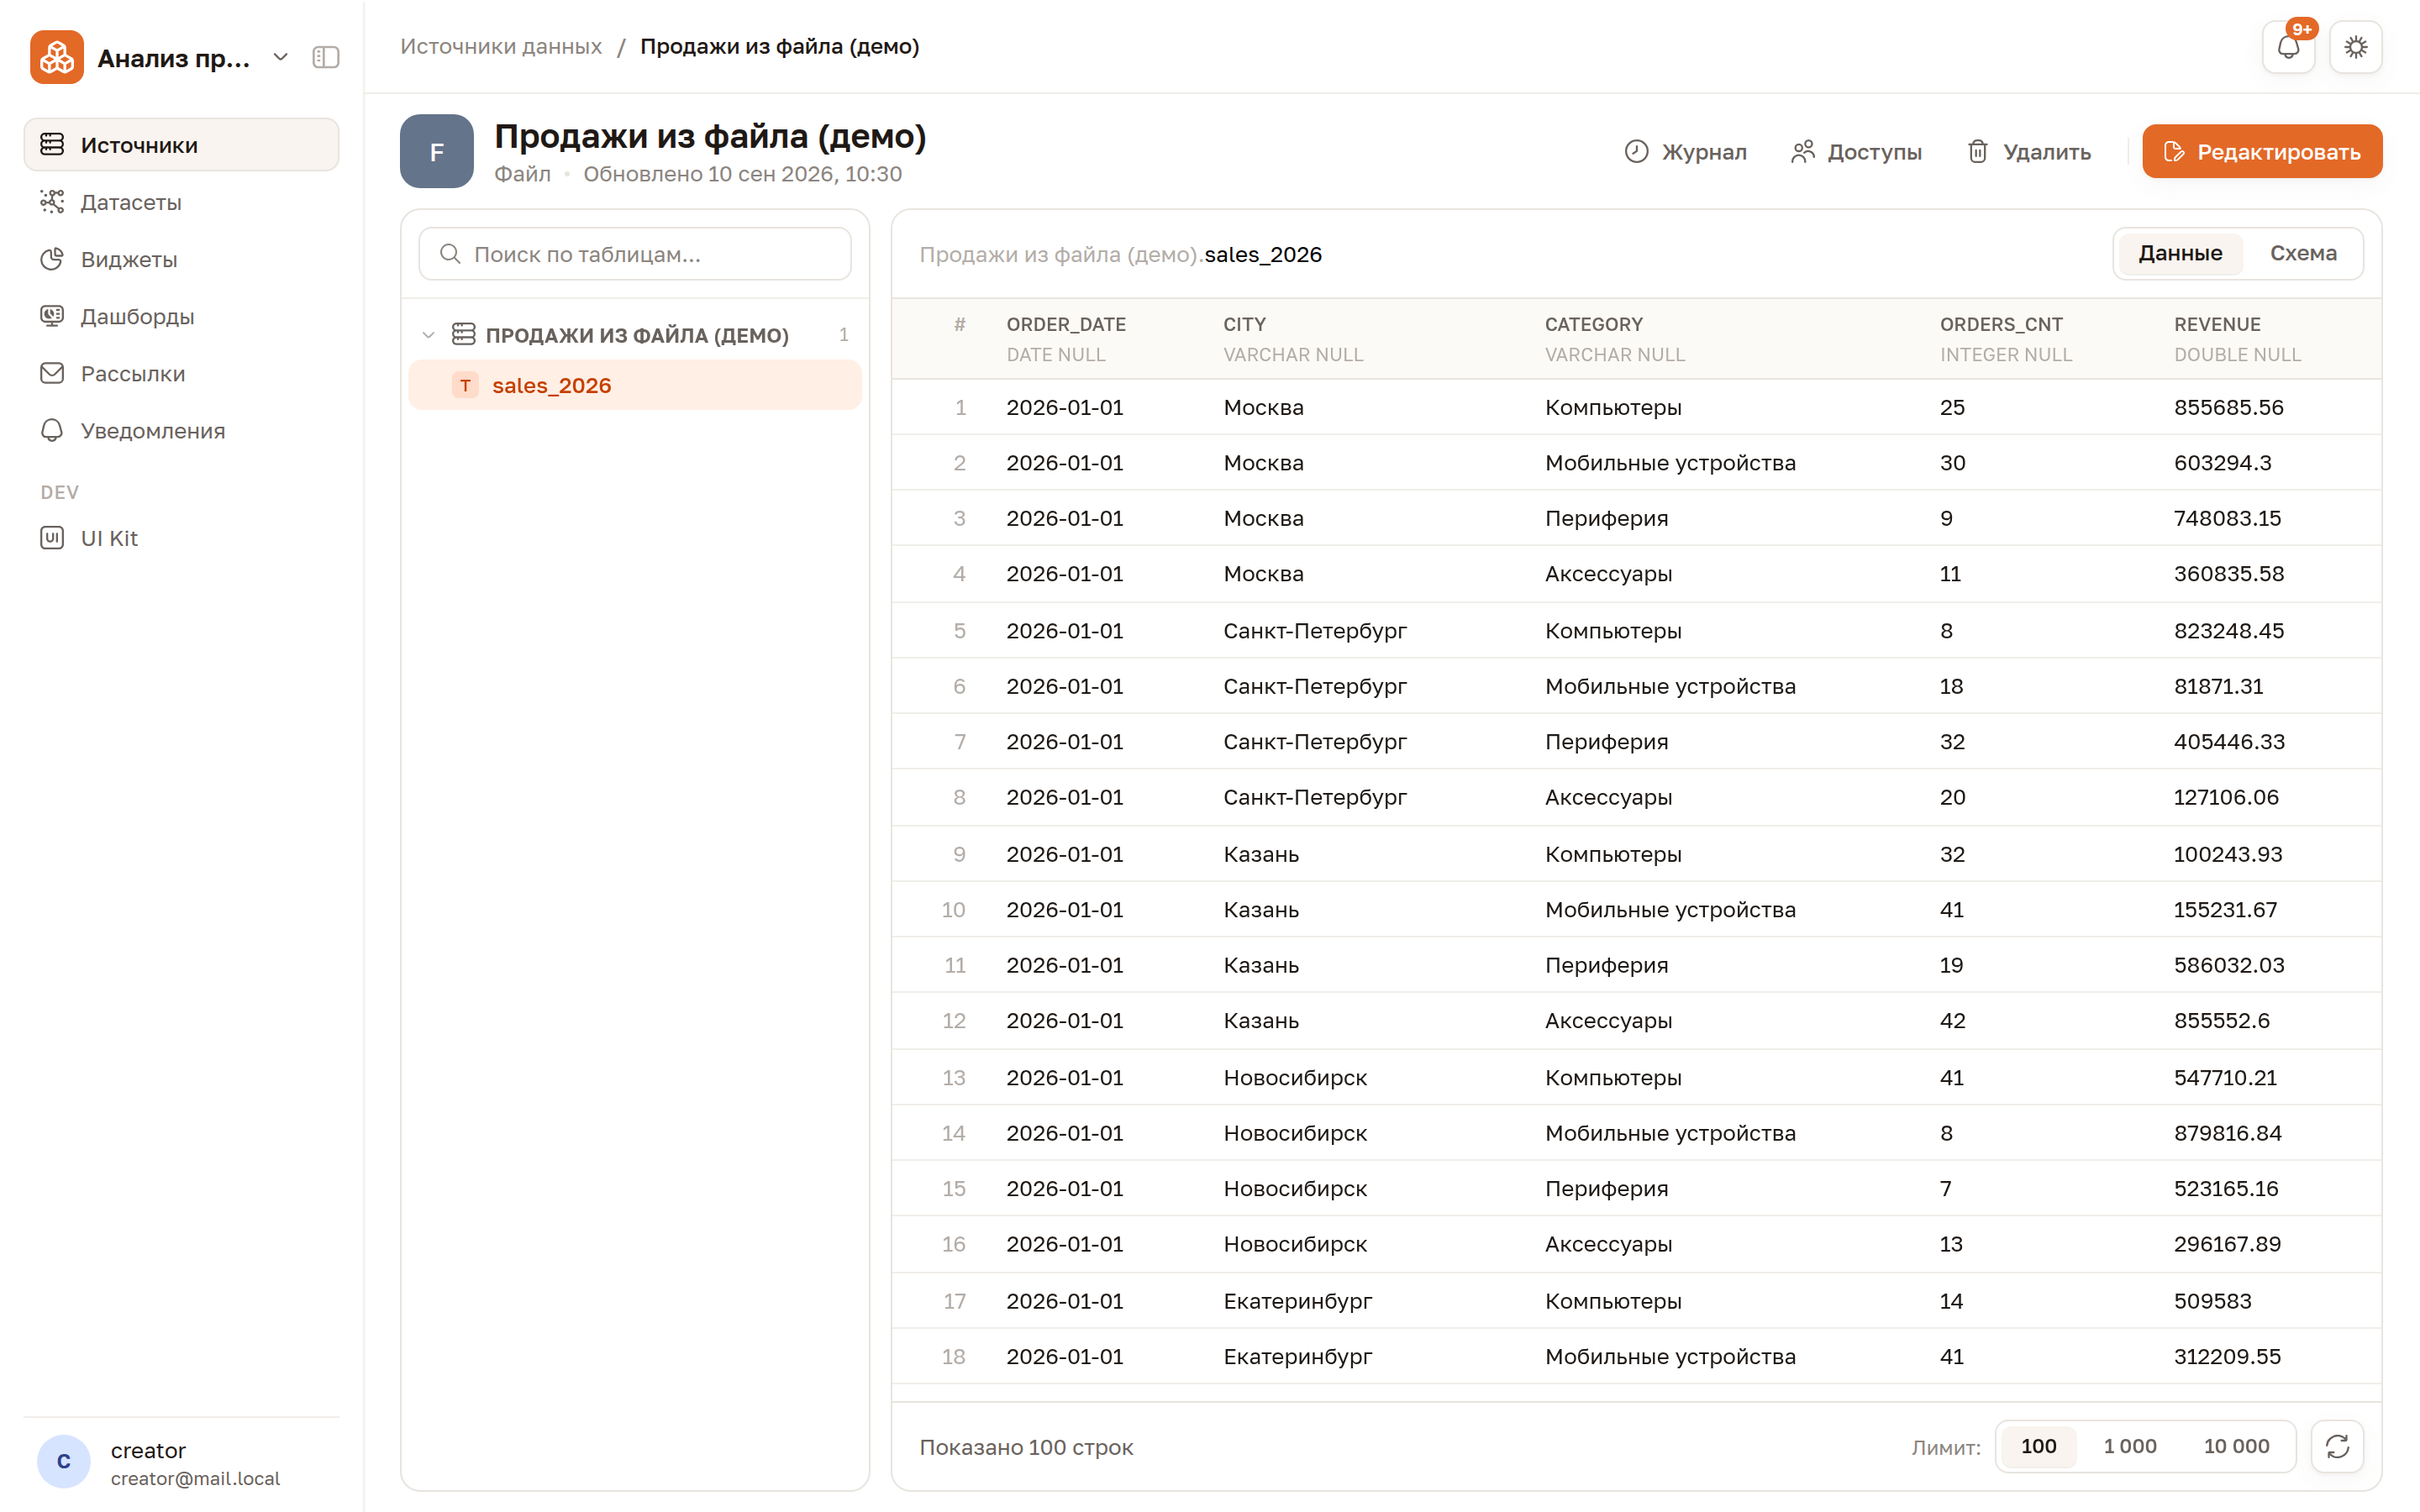
Карточка устроена как у любого источника: слева дерево с единственной таблицей, справа вкладки Данные и Схема, внизу счётчик строк и переключатель лимита — подробнее в разделе Просмотр данных и схемы.
Файл с несколькими таблицами
Zip-архив и книга Excel содержат не одну таблицу, а несколько: каждая запись архива и каждый лист книги читаются отдельным объектом. Архив sales_2026.zip с файлами sales_q1.csv и sales_q2.csv даёт в источнике две таблицы — sales_q1 и sales_q2.
Переключатель Склеить таблицы файла в одну в блоке Разбор файла сводит их в одну таблицу. Она называется по имени файла без расширения: у того же архива останется одна таблица sales_2026.
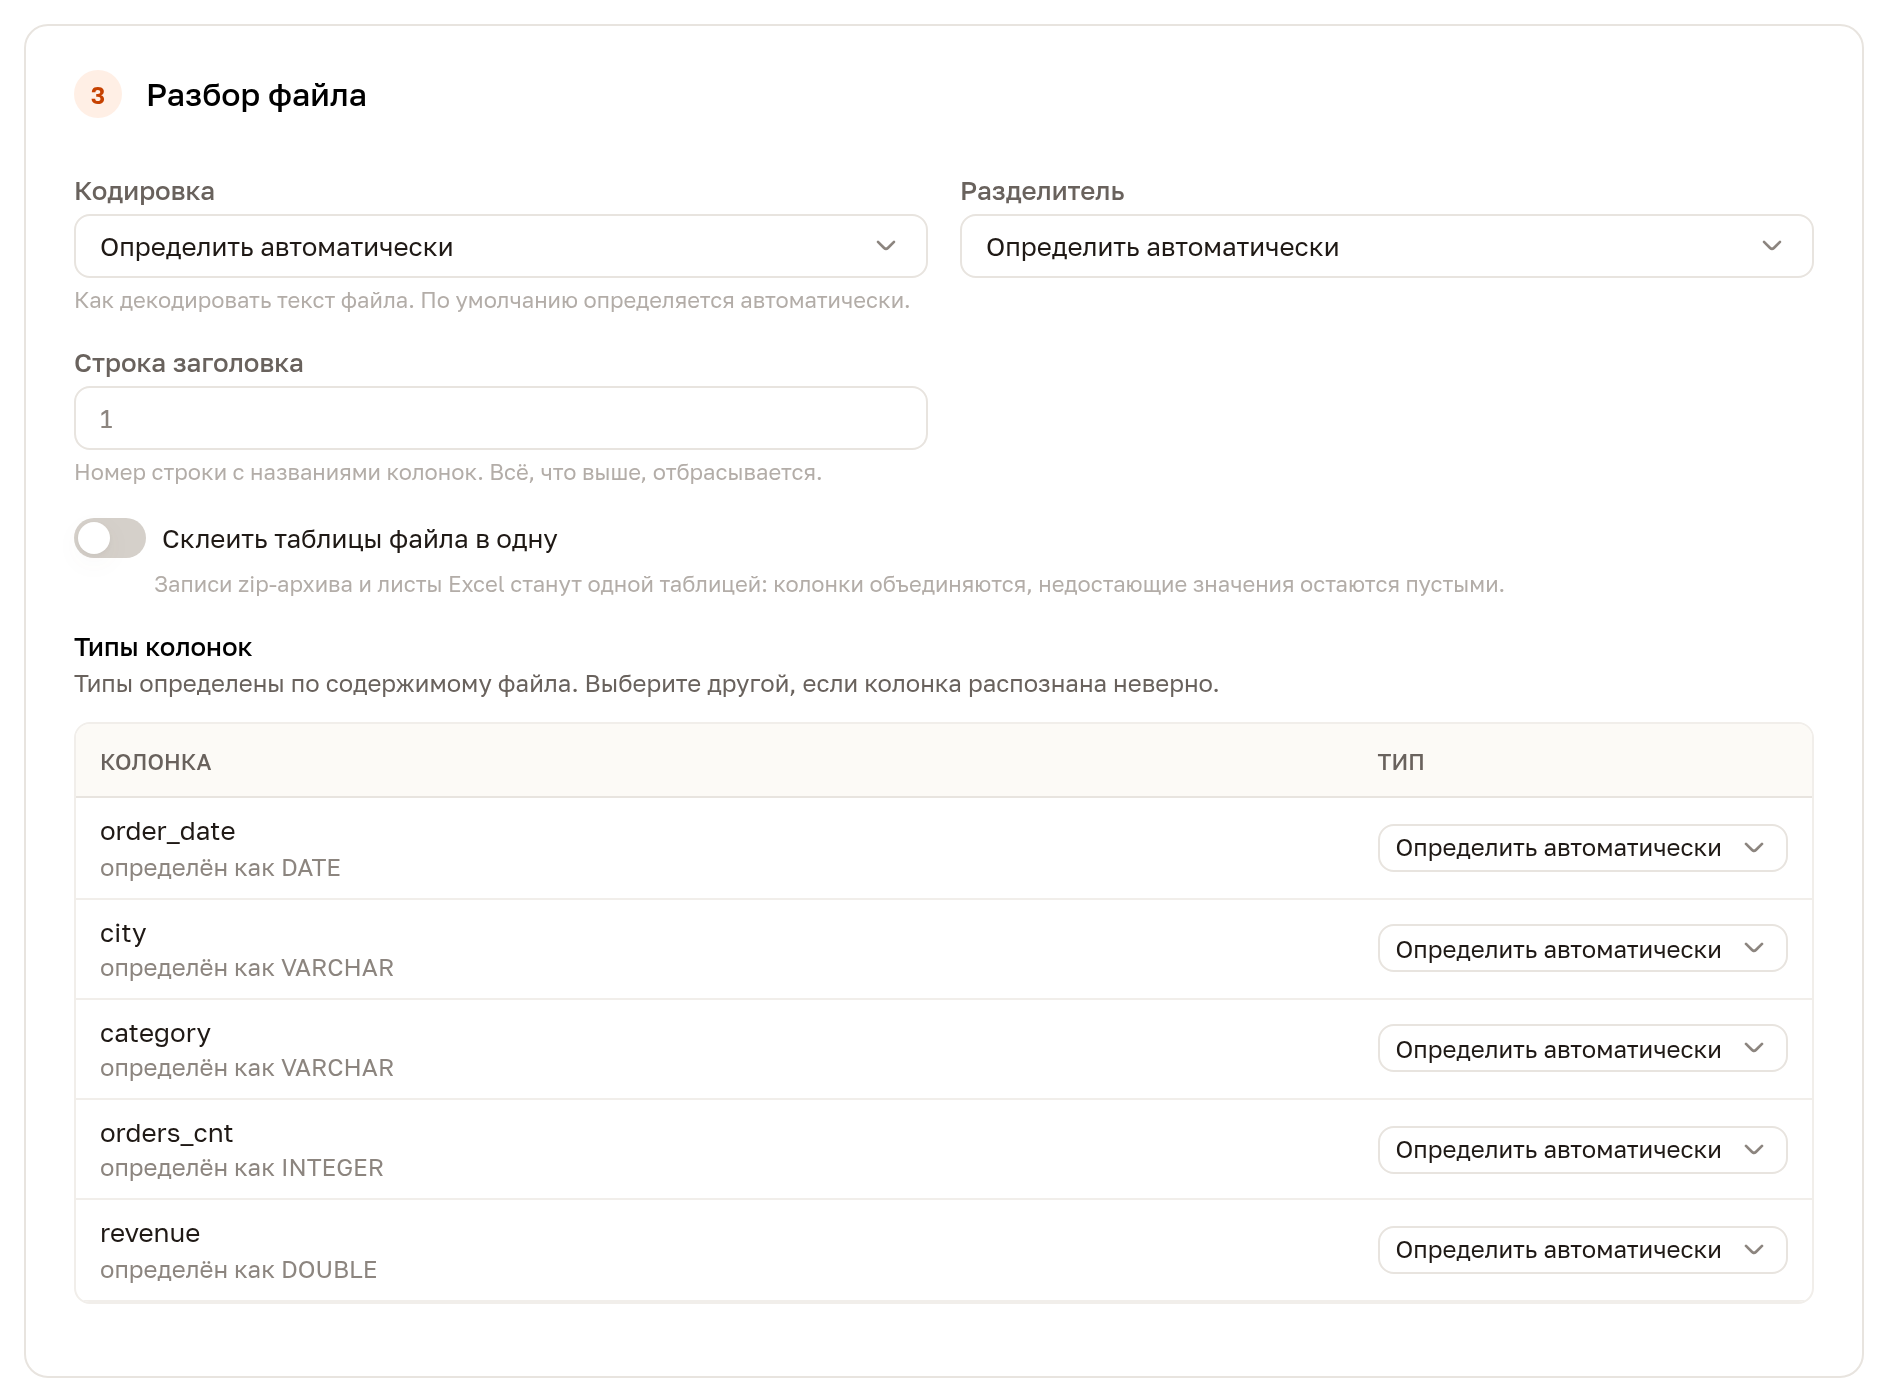
Колонки при этом объединяются: в итоговой таблице оказывается весь набор колонок из всех частей, а там, где в исходной таблице колонки не было, остаётся пустое значение. Если в квартальных выгрузках второй файл содержит лишнюю колонку manager, она появится и у строк первого — со значением «null».
Типы колонок с одинаковыми именами платформа приводит к общему: числовые расширяются до более широкого, а если типы несовместимы — колонка становится текстовой.
Когда склейка нужна
Части одного набора — выгрузки по кварталам, филиалам или месяцам — удобнее анализировать одной таблицей: не придётся собирать их UNION в SQL-блоке и связывать между собой в датасете.
Одна таблица остаётся под своим именем
Если в файле всего одна таблица, переключатель ничего не меняет: CSV внутри архива сохранит собственное имя, а не получит имя архива.
Настройка учитывается и при выгрузке в витрину: в режиме извлечения ETL читает файл так же, как показал источник при выборе объектов.
Типы колонок
Платформа сама распознаёт числа, даты в формате ГГГГ-ММ-ДД и логические значения. Остальное она читает как текст: дату вида 31.12.2024 или числовую колонку, где встретилось постороннее значение. По текстовой колонке нельзя построить ось времени или сумму, поэтому тип задаётся вручную: откройте источник на редактирование — под настройками разбора появится список колонок.
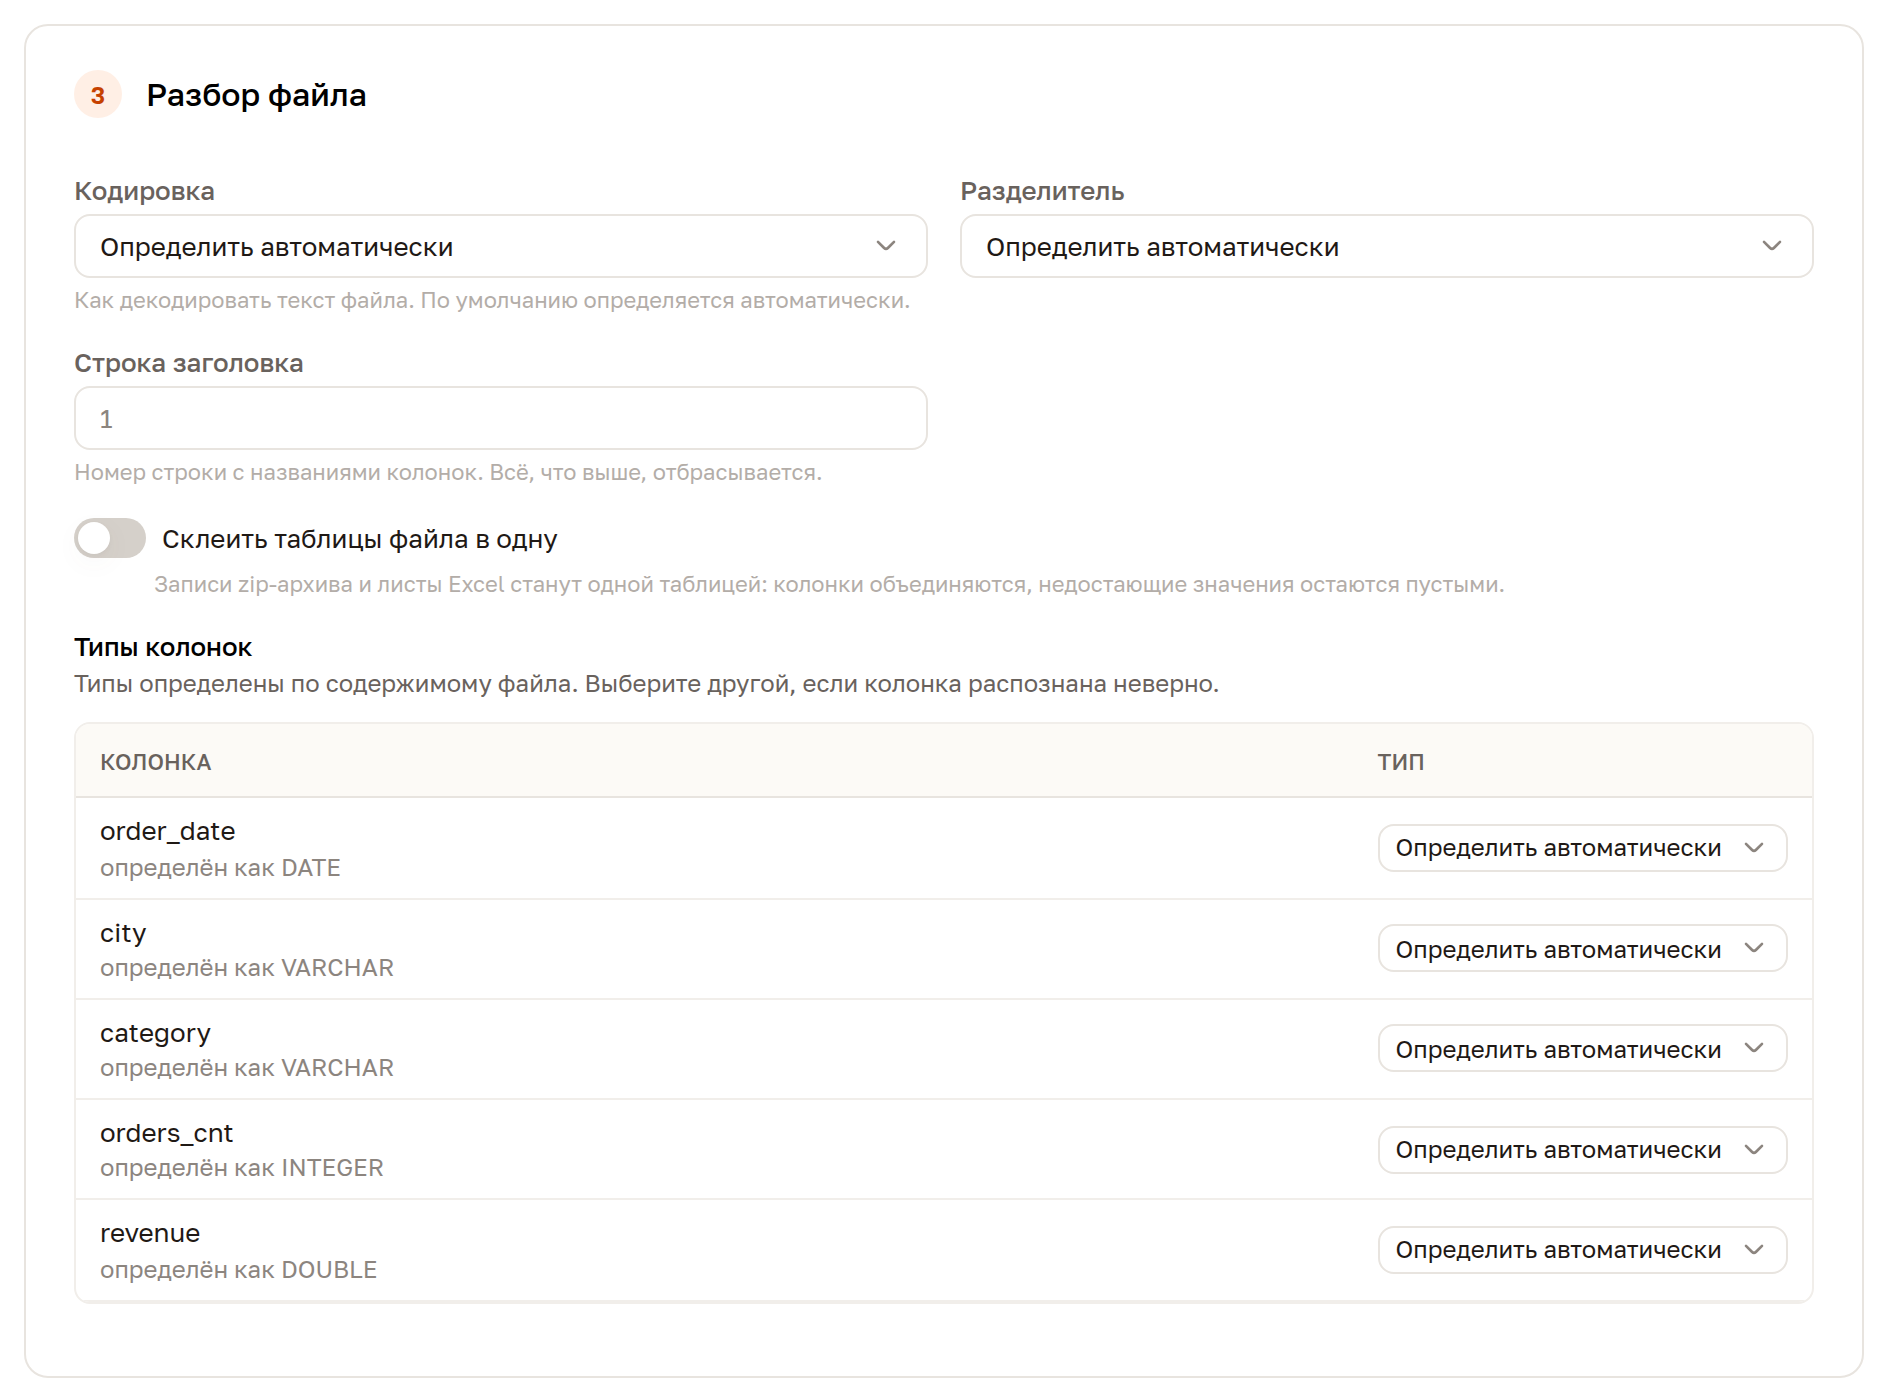
Под именем колонки платформа пишет, каким типом она читается сейчас, а справа — выпадающий список: Определить автоматически, Целое, Целое (8 байт), Дробное, Логическое, Дата, Дата и время, Текст. У двух последних рядом появляется поле формата — шаблон вида dd.MM.yyyy, по которому читать значение.
Список колонок появляется только у сохранённого источника
При создании источника его ещё нет: колонки становятся известны после того, как файл разобран. На шаге подключения вместо списка стоит подсказка «Типы колонок можно будет задать после сохранения». Порядок такой — сохраните источник, откройте его снова кнопкой Редактировать и задайте типы.
Значения, которые не приводятся к выбранному типу, становятся пустыми, а файл продолжает читаться — рядом с колонкой платформа показывает, сколько их: «4 не приведено». Над списком стоит общий счётчик «Не приведено значений: N» по всем колонкам сразу. Это счётчик, а не ошибка: по нему видно, что тип выбран неверно или данные в колонке смешаны. Колонки, которым тип задан руками, считает соседний счётчик «Задано вручную: N» — по нему видно, где платформа определила тип сама, а где нет.
У книги Excel список колонок свой на каждый лист — над ним появляется выбор листа; если листы склеены в одну таблицу, список тоже один. У источника S3 блок тот же, и настройки применяются ко всем файлам шаблона сразу: под одним шаблоном файлы считаются однородными.
Русская запись числа распознаётся сама
Числа вида 1385,98 читаются наравне с 1385.98 — и при автоопределении, и при ручном типе Дробное. В книге Excel так же читаются суммы под денежным форматом: 1 234,56 ₽ разбирается в 1234.56.
Колонку, где рядом с суммами попадаются н/д или прочерки, автоопределение оставит текстовой: задайте ей тип Дробное, и числа разберутся, а посторонние значения станут пустыми и попадут в счётчик непреобразованных.
S3
Тип S3 подключает объектное хранилище — Amazon S3 или совместимое, например MinIO.
| Поле | Описание |
|---|---|
| Endpoint | Адрес хранилища, например https://s3.amazonaws.com |
| Регион | Регион бакета, например us-east-1 |
| Бакет | Имя бакета |
| Шаблон путей | Glob-маска объектов внутри бакета, например data/*.parquet |
| Access key, Secret key | Ключи доступа |
| Path-style адресация | Включите для MinIO и других S3-совместимых хранилищ без virtual-hosted адресации |
Ниже — тот же блок Разбор файла, что и у обычного файла. Кнопка Проверить подключение доступна до сохранения.
Как читается шаблон путей
Шаблон — это glob-маска: **/*.csv возьмёт все CSV в бакете на любой глубине, data/2026-*.csv — только файлы за 2026 год в папке data.
Все подошедшие файлы сливаются в одну таблицу: считается, что это части одного набора с одинаковыми колонками. Имя таблицы платформа берёт из неизменяемой части шаблона — последней папки перед маской, а если её нет, то из имени бакета. Например, при шаблоне **/*.csv в бакете sales-archive объект будет называться sales_archive.
Типы колонок определяются автоматически: текстовые становятся VARCHAR, числовые — INTEGER. Если тип определён неверно, задайте его вручную — см. Типы колонок.
Схема читается по первым пяти файлам
Чтобы определить состав колонок, платформа разбирает не весь набор, а несколько первых файлов (по умолчанию пять). Если у шестого файла окажется лишняя колонка, в таблицу она не попадёт — держите файлы набора одинаковыми по структуре.
Новый файл появляется не сразу
Результат разбора кешируется на несколько минут (по умолчанию пять). Если вы только что залили файл в бакет, а в превью его ещё нет — подождите и обновите: до истечения срока источник продолжает отдавать прежний набор строк.
Если по шаблону не нашлось ни одного файла, платформа сообщает об этом: «По паттерну не найдено файлов». Слишком большой набор она тоже не возьмёт: по умолчанию под шаблон попадает не больше 10 000 объектов, а файлы, которые читаются целиком (XLSX, документный JSON, ZIP), ограничены размером в 256 МБ. Оба предела задаются при развёртывании — см. Кеши и лимиты.
Почему S3 стоит рядом с файлами, а не с базами
S3 — объектное хранилище, но платформа работает с ним как с файлами: она не выполняет там SQL, а читает CSV или Parquet по маске и разбирает их тем же способом, что и загруженный файл. Поэтому у S3 и типа «Файл» общий блок Разбор файла.
Что дальше
- Датасеты — как собрать набор данных поверх загруженного файла.
- Справочник типов и портов — остальные типы источников.