
Оформление
Выбор модели
Помощник генерирует SQL по структуре источника. Задача узкая, и самые дорогие модели преимущества в ней не дают: с ней одинаково справляются и флагманские модели, и недорогие быстрые. Решают три свойства — скорость, устойчивость сервиса и склонность выдумывать несуществующие поля.
Почему важна скорость одного вызова
На один вопрос пользователя платформа обращается к модели до трёх раз подряд:
- Отбор таблиц — если в источнике больше 12 таблиц, платформа сначала спрашивает модель, какие из них нужны для запроса.
- Генерация SQL — по структуре отобранных таблиц.
- Исправление — если запрос не прошёл проверку на структуре источника, платформа передаёт модели текст ошибки и просит исправить. Одна попытка.
На каждое обращение к модели отведено 60 секунд, а ждёт пользователь их сумму. Поэтому модель с типичным ответом в 4 секунды даёт около 12 секунд ожидания, а редкий медленный ответ в 14 секунд превращается в 40. Если перед платформой стоит веб-сервер организации, время ответа ограничивает ещё и он — обычно теми же 60 секундами на весь запрос.
Смотрите не только на среднее время
Выбирая между двумя моделями, сравнивайте и самый медленный ответ из серии. Модель со средним временем 1,5 с и худшим 6 с надёжнее модели со средним 3,9 с и худшим 14 с, даже если обе отвечают верно.
На что смотреть при выборе
| Свойство | Почему важно | Как проверить |
|---|---|---|
| Время ответа | Складывается втрое на одном вопросе | Кнопка Проверить, несколько раз подряд |
| Число сервисов-исполнителей | Модель с единственным исполнителем отказывает при высокой нагрузке | Карточка модели в каталоге сервиса |
| Отказ от выдумывания | Помощник должен сообщать о нехватке данных, а не давать неверный запрос | Вопрос о заведомо отсутствующих данных |
| Размер контекста | Структура источника с сотнями таблиц должна поместиться в запрос | Карточка модели в каталоге |
Модель с единственным исполнителем отказывает под нагрузкой
Дешевизна модели часто означает общую очередь
Агрегаторы раздают часть моделей через общую квоту одного исполнителя — этим и объясняется низкая цена. При работе нескольких пользователей такая модель начинает отвечать отказом 429 TOO_MANY_REQUESTS с пояснением insufficient_quota, и помощник сообщает о недоступности провайдера.
Отказы приходят не постоянно, а на части запросов, поэтому одиночная проверка кнопкой Проверить их не показывает. Нажмите её десять раз подряд: если хотя бы один ответ завершился отказом, модель для работы нескольких пользователей не годится.
На карточке модели в каталоге сервиса видно, сколько исполнителей её отдают. Выбирайте модели с несколькими — тогда при отказе одного сервис передаёт запрос следующему.
Проверка на выдумывание
Помощник обязан отвечать INSUFFICIENT_SCHEMA, когда данных для ответа нет. Задайте вопрос о том, чего в источнике заведомо не может быть — например, о рейтинге удовлетворённости клиентов в таблице продаж. Правильное поведение: помощник сообщает, что запрос нельзя выполнить имеющимися данными. Неправильное: выдаёт SQL, где нужное поле подставлено из похожего по смыслу.
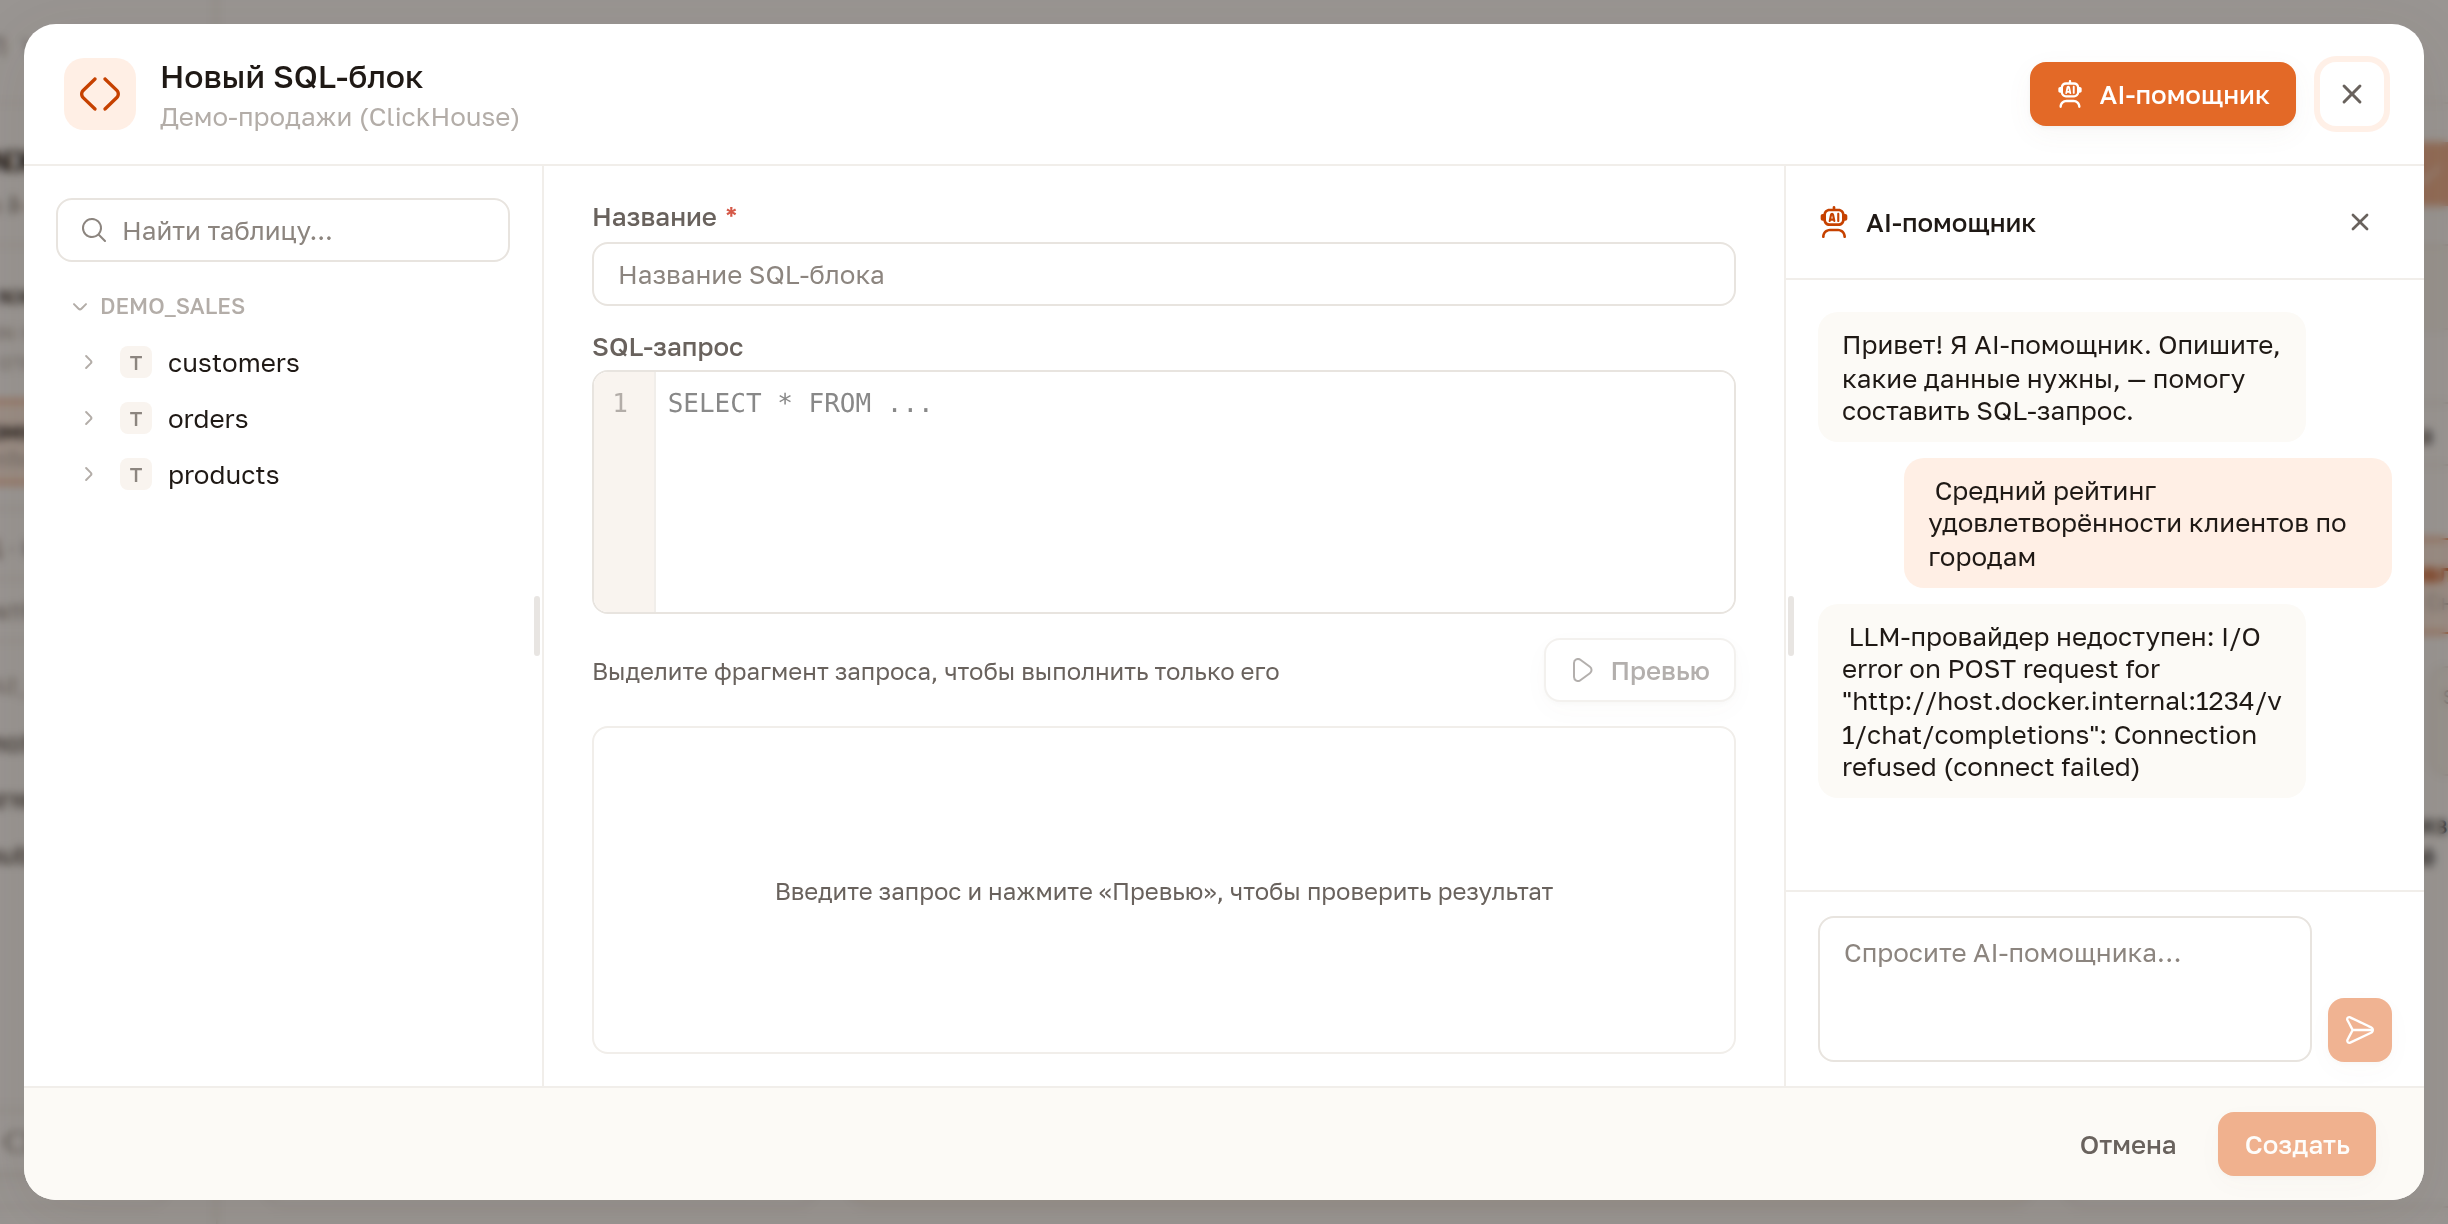
Это самая частая ошибка недорогих моделей, и она опаснее медленного ответа: пользователь получает правдоподобный запрос с неверными данными.
Модели, пригодные для помощника
Значения времени — на источнике из 45 таблиц, при отключённых рассуждениях. Цены указаны за миллион токенов, входящих и исходящих; каталоги сервисов обновляются, поэтому перед покупкой сверьте цену на карточке модели.
| Модель | Типичный ответ | Самый медленный | Цена | Примечание |
|---|---|---|---|---|
google/gemini-3.1-flash-lite | 1,4 с | 6,2 с | $0,25 / $1,50 | Ровное время, ошибок не даёт |
x-ai/grok-4.3 | 1,7 с | 2,5 с | $1,25 / $2,50 | Самый узкий разброс, дороже прочих |
openai/gpt-5.6-luna | 2,4 с | 3,8 с | $0,20 / $1,20 | Через агрегаторы отвечает заметно медленнее |
qwen/qwen3.7-plus | 2,6 с | 4,0 с | $0,32 / $1,28 | |
deepseek/deepseek-v4-pro | 2,9 с | 8,7 с | $0,53 / $1,05 | |
tencent/hy3 | 3,8 с | 13,9 с | $0,13 / $0,53 | Дешёвая, но с длинным хвостом времени |
Модели, которые для помощника не подходят, хотя отвечают верно: grok-4.6 (14 с в среднем), gemini-3.1-pro (10,6 с), glm-5.3 (7,2 с). На цепочке из трёх вызовов они выходят за отведённое время.
Проверяйте модель на том сервисе, где будете работать
Одна и та же модель у разных сервисов ведёт себя по-разному: у одного отвечает за 2,4 с, у другого — за 5,7 с, потому что запрос уходит разным исполнителям. Модель, отказывающая по квоте у одного сервиса, у другого может работать без отказов.
Поэтому переносить выбор модели с одного сервиса на другой без проверки не стоит.
Отключение рассуждений
Модель с внутренними рассуждениями тратит на них основную часть времени ответа. В ответе пользователю рассуждения не показываются, но оплачиваются как исходящие токены — и занимают до трёх четвертей их объёма.
Название параметра зависит от сервиса, поэтому проверьте его кнопкой — сохранять для этого не нужно:
| Сервис модели | Параметр |
|---|---|
| Агрегаторы моделей | {"reasoning": {"enabled": false}} |
| LM Studio, Ollama | {"reasoning_effort": "none"} |
Часть моделей рассуждения отключать не позволяет
Некоторые модели отвечают ошибкой 400 BAD_REQUEST с пояснением «Reasoning is mandatory». Для них параметр из поля нужно убрать целиком — иначе помощник не будет работать вовсе.
Без рассуждений модель хуже отказывается от невыполнимых задач
Отключение ускоряет ответ вдвое-втрое, но у части недорогих моделей вместе с рассуждениями пропадает и осторожность: вместо сообщения о нехватке данных они выдают SQL с выдуманными полями. После отключения повторите проверку на выдумывание.
Ещё два параметра
| Параметр | Значение | Зачем |
|---|---|---|
{"temperature": 0} | Платформа своего значения не подставляет — без этого ключа работает умолчание сервиса | Одинаковый вопрос даёт одинаковый запрос |
{"max_tokens": 1500} | Предел длины ответа | Ограничивает стоимость одного вызова; если лимита не хватит, помощник ответит «Ответ модели неполный», а не обрезанным SQL |
Итоговое содержимое поля Доп. параметры вызова для агрегатора моделей:
json
{"temperature": 0, "max_tokens": 1500, "reasoning": {"enabled": false}}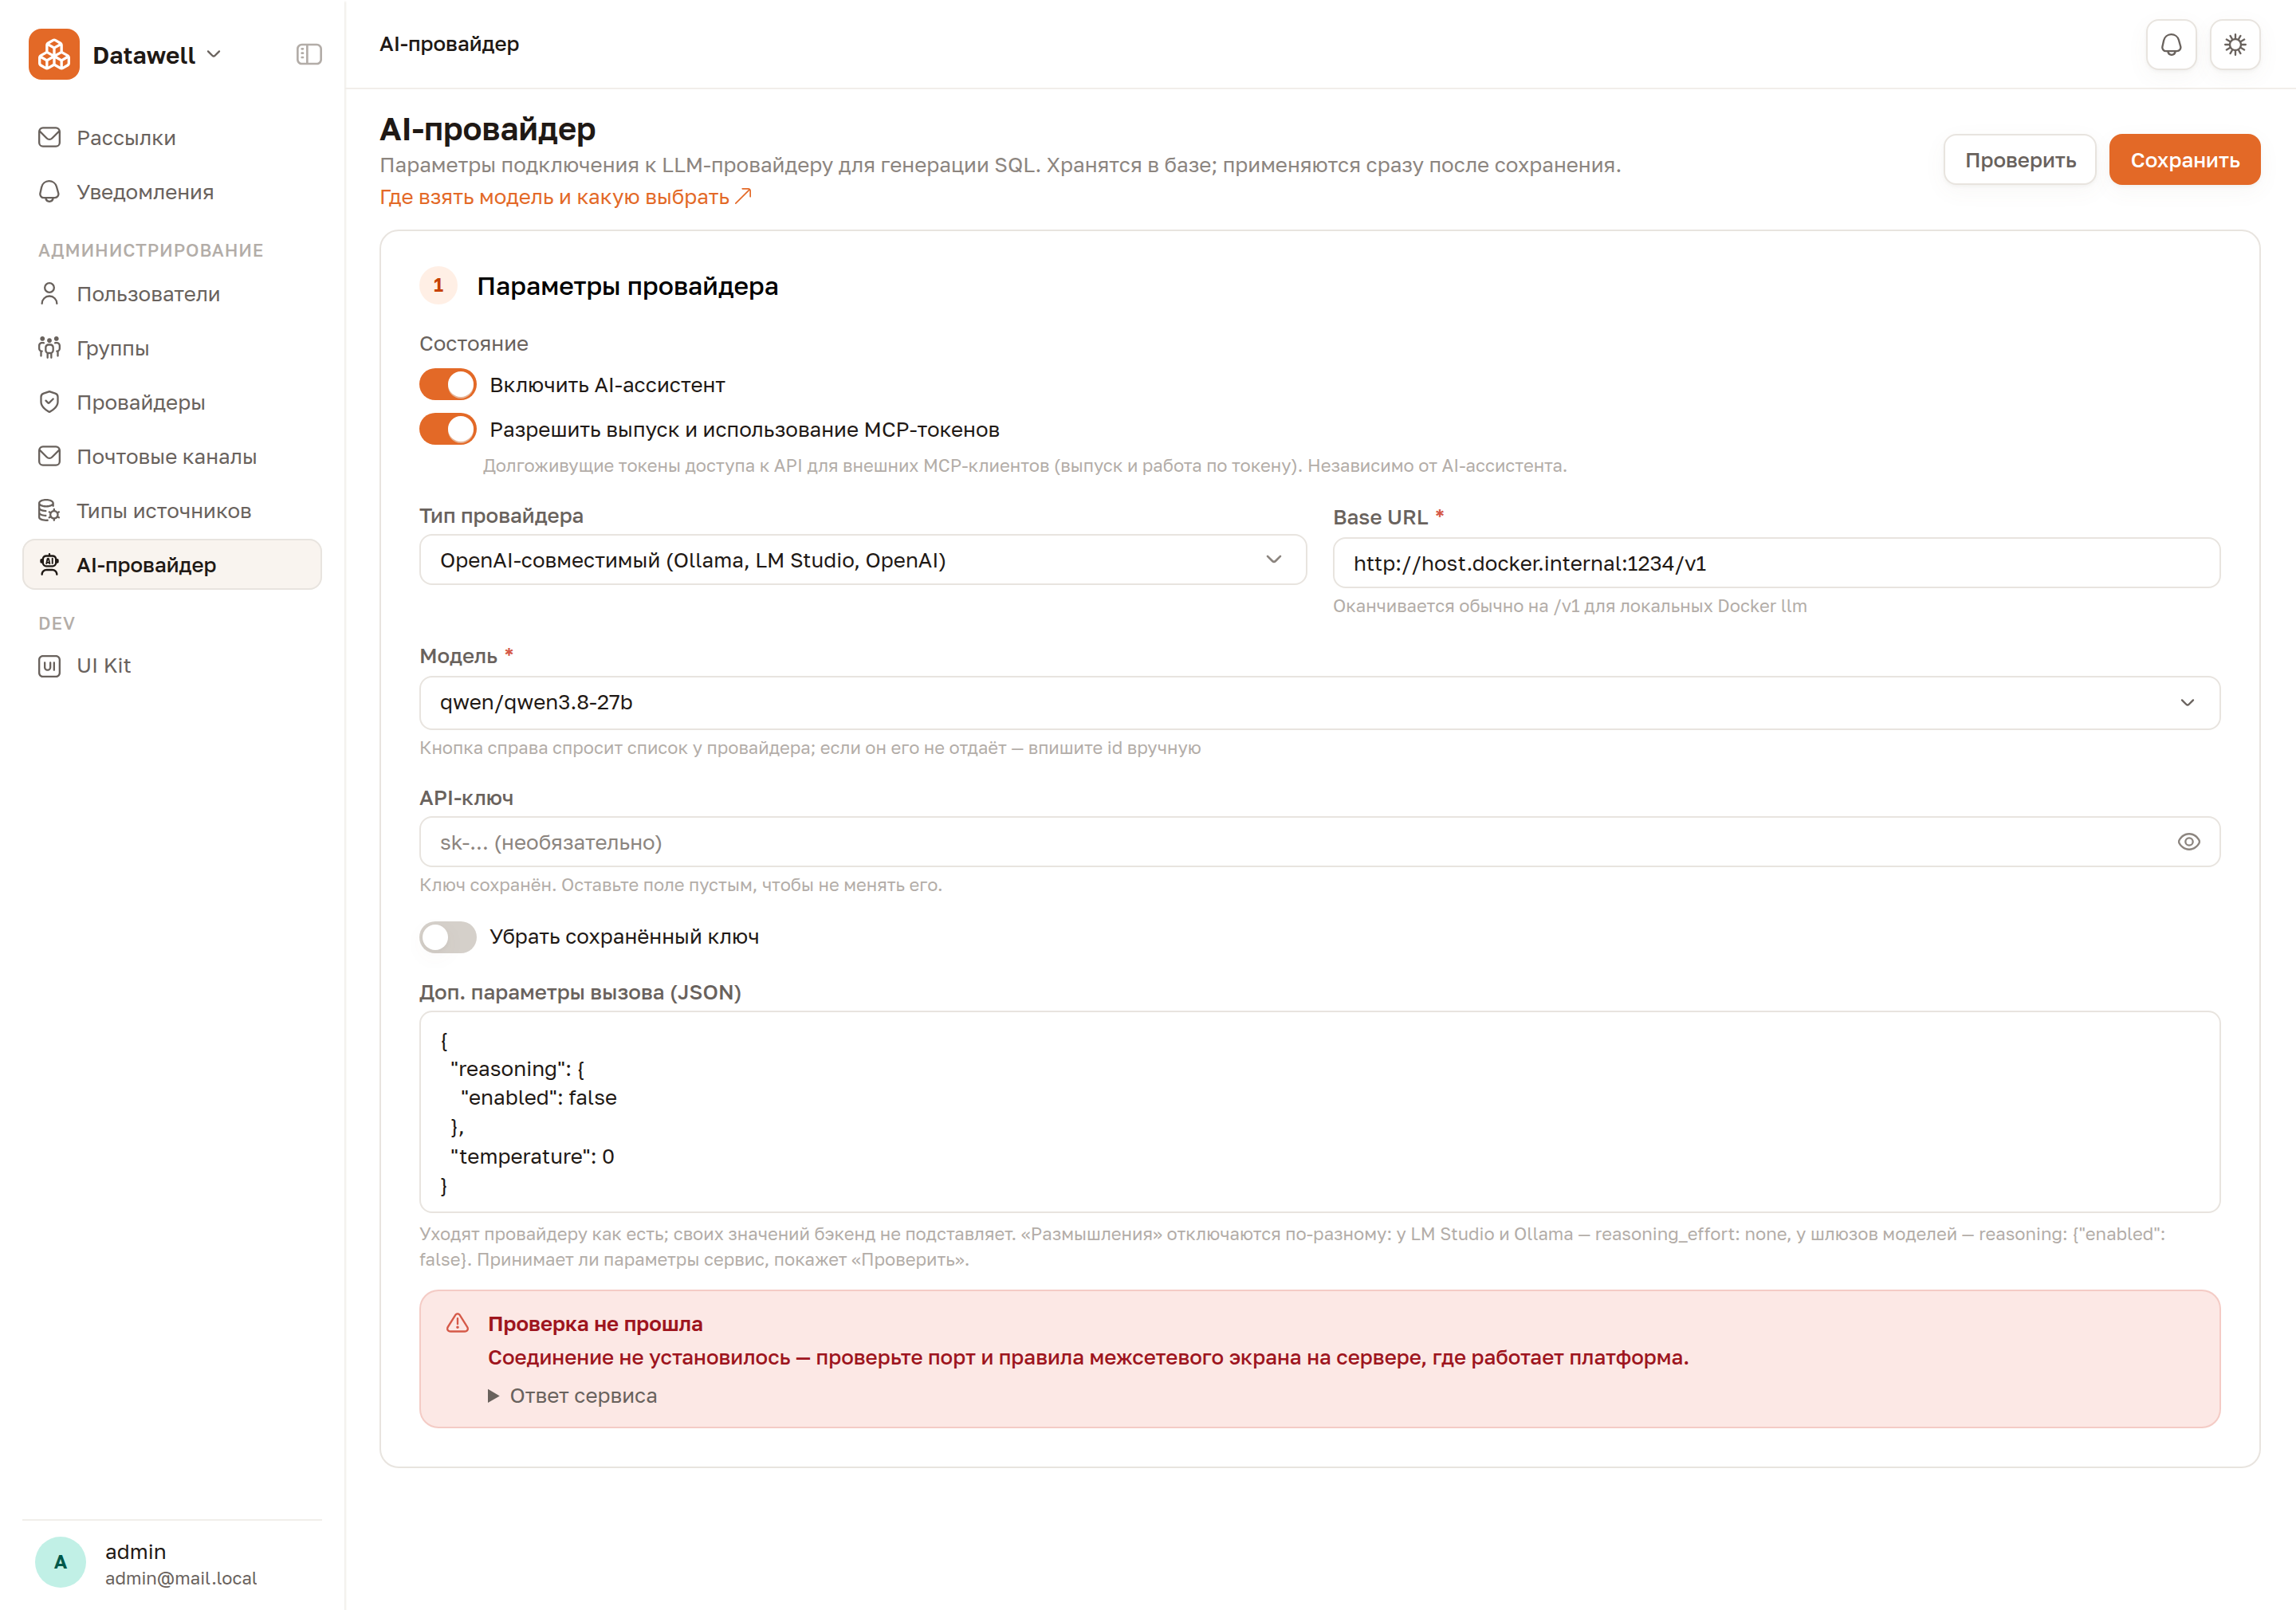
Проверка — основной инструмент подбора: она называет модель, показывает время ответа и число токенов, а по строке «без размышлений» видно, что параметр отключения сработал. Если вместо неё стоит «из них N на размышления», параметр сервис не понял. Проверка идёт по тому, что сейчас в форме, поэтому модели перебирают, не сохраняя каждую.
Сколько стоит работа помощника
Запросы помощника короткие: структура отобранных таблиц занимает 200–600 токенов, готовый SQL — около 50. Один вопрос пользователя с отбором таблиц обходится примерно в $0,00025 на модели среднего класса — порядка двух копеек.
| Нагрузка | Запросов в месяц | Расход в месяц |
|---|---|---|
| 100 вопросов в день | 3000 | около 70 ₽ |
| 400 вопросов в день | 12 000 | около 270 ₽ |
| 2000 вопросов в день | 60 000 | около 1400 ₽ |
Расход растёт вместе с числом таблиц в источнике: у источника на сотни таблиц список для отбора занимает несколько тысяч токенов, и запрос дорожает втрое.
Выбор модели влияет на расход сильнее выбора сервиса
Наценка агрегатора — около 20 %, а разница в цене между подходящими моделями достигает двух-трёх раз. Если расход имеет значение, сравнивайте прежде всего модели, а не сервисы.
Что дальше
- Где взять модель — сервисы моделей и доступность из сети организации.
- AI-провайдер — поля раздела и проверка подключения.
- AI-помощник — как помощник выглядит для пользователя.